
Il PDF di Schrödinger: stesso hash, due contenuti diversi

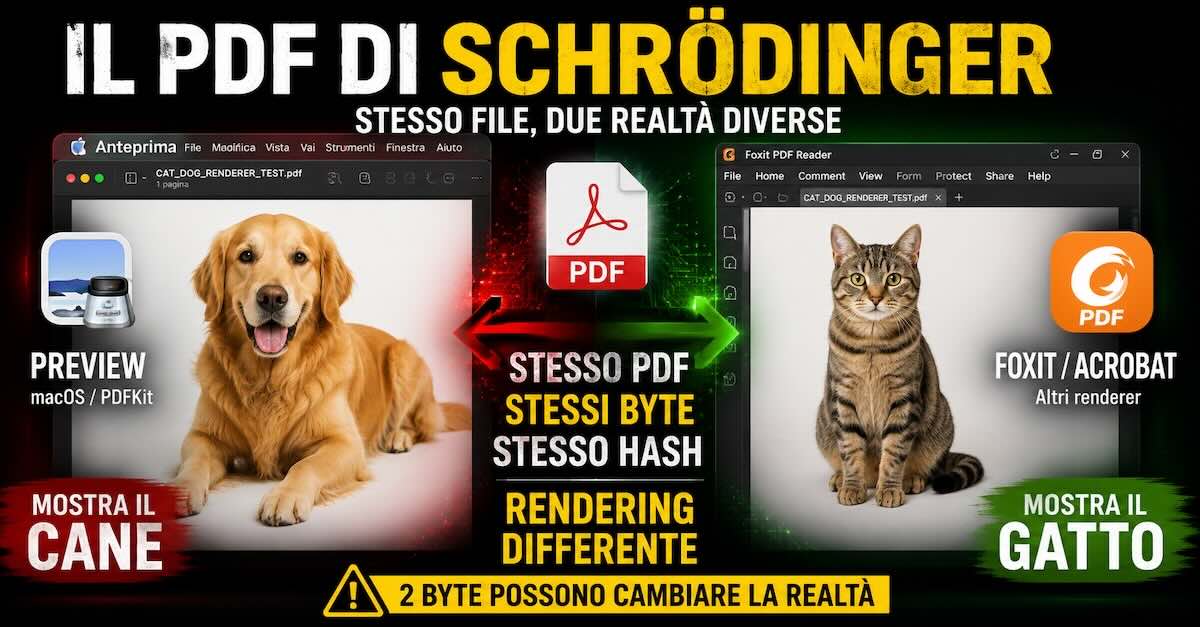
Nell’informatica forense, la PDF forensics si occupa dell’acquisizione e dell’analisi tecnica dei documenti PDF: struttura interna, immagini, metadati, revisioni, possibili manipolazioni e firme digitali. Anche l’esame delle firme rappresentate graficamente richiede di distinguere ciò che il documento contiene da ciò che viene mostrato sullo schermo.
Ci sono casi nei quali questa analisi diventa più complessa a causa di differenze di interpretazione o di rendering, dovute alla struttura del documento, al software utilizzato o alla loro interazione. Tali differenze possono anche essere sfruttate intenzionalmente da chi costruisce il PDF.
Ci siamo imbattuti in un PDF nel quale alcune immagini non comparivano in Anteprima (Preview) su macOS, pur essendo visibili con altri software. Al posto di alcune fotografie apparivano riquadri grigi; lo stesso documento, aperto con altri visualizzatori, mostrava invece le immagini.
L’indagine è partita dalle immagini della copertina: prima di considerarle mancanti o danneggiate, abbiamo verificato che fossero effettivamente presenti negli oggetti del PDF.
Attraverso una serie di test sempre più ridotti è stato possibile circoscrivere una differenza di comportamento alla gestione di particolari immagini JPEG 2000 con campi della File Type Box che dichiarano il formato JPX. Questa dichiarazione va distinta dalla piena conformità del container allo standard.
Il risultato è particolarmente interessante: abbiamo costruito due PDF che differiscono esclusivamente per due byte nell’intero file, con lo stesso codestream JPEG 2000. Nel test effettuato con PDFKit su macOS, una variante mostra l’immagine e l’altra produce una pagina bianca.
Abbiamo poi sfruttato la differenza di rendering per costruire un secondo esperimento: un solo PDF che mostra un cane con un renderer e un gatto con un altro. Il file non cambia; cambia la sua rappresentazione visiva.
La struttura del PDF e le immagini contenute
Per capire il problema bisogna innanzitutto distinguere il documento PDF dal modo in cui viene visualizzato.
Un PDF è un contenitore strutturato che può includere testo, font, grafica vettoriale, immagini raster, trasparenze, profili colore, maschere, livelli e numerosi altri oggetti. Quando apriamo il documento non stiamo necessariamente vedendo qualcosa di già “disegnato”: è il renderer PDF a interpretare quegli oggetti e a trasformarli nei pixel mostrati sul display.
Applicazioni differenti possono utilizzare motori differenti, mentre applicazioni diverse possono anche condividere lo stesso motore. Anteprima e altre applicazioni Apple utilizzano le tecnologie PDF del sistema; altri visualizzatori impiegano implementazioni differenti. Anche nel browser il risultato dipende dal componente che apre il PDF: per descrivere una prova servono quindi applicazione, versione e modalità di apertura, oltre al sistema operativo.
Un documento leggibile da un renderer può dunque evidenziare un limite, un errore o una diversa gestione dell’input in un altro. Il fatto che un software mostri l’immagine, da solo, non dimostra però che l’intero documento sia conforme alle specifiche.
Le immagini “scomparse” erano ancora dentro il PDF
Nel documento originario, gli Image XObject delle fotografie erano presenti, con dimensioni e stream apparentemente coerenti. Altri visualizzatori riuscivano a decodificarli e a mostrarli: l’assenza sullo schermo non corrispondeva all’assenza dei dati nel PDF.
Le sei immagini problematiche della copertina condividevano una caratteristica:
JPEG 2000 + CMYK + filtro PDF /JPXDecode.
Il filtro /JPXDecode, introdotto con PDF 1.5, è il meccanismo previsto per decodificare immagini JPEG 2000. Il suo nome non significa che ogni stream debba avere il brand jpx : lo stesso filtro è usato anche per immagini con container JP2. La specifica disciplina inoltre il rapporto tra le informazioni colore interne all’immagine e quelle dell’Image XObject.
La presenza di /JPXDecode, quindi, non costituisce di per sé un errore.
I formati JP2 e JPX
JPEG 2000 comprende una famiglia di specifiche. La Part 1 definisce il sistema di codifica principale e il formato JP2; la Part 2 introduce estensioni alla codifica e il formato JPX, con funzionalità aggiuntive per la descrizione del colore, più codestream e la composizione delle immagini. È essenziale distinguere il codestream compresso dal container che lo racchiude.
Un container JP2 è organizzato in box. Lo schema seguente descrive i quattro box di primo livello presenti anche negli stream del testcase; non è una descrizione completa dei requisiti di un JPX conforme. Un codestream JPEG 2000 privo di container, invece, non presenta questa struttura a box:
JPEG2000 Signature Box
File Type Box       (ftyp)
JPEG2000 Header     (jp2h)
Codestream          (jp2c)
La File Type Box (ftyp) contiene un brand principale, un valore di versione minore e una lista di compatibilità. Nell’analisi abbiamo confrontato la dichiarazione:
brand = "jpx "con:
brand = "jp2 "Analizzare il codestream JPEG 2000
Per distinguere le proprietà delle immagini da quelle del container abbiamo esaminato i marker del codestream. È importante separare le immagini del documento originario dal testcase sintetico distribuito qui: non sono lo stesso insieme di dati.
Nei due PDF definitivi del testcase, l’immagine è di 512 × 512 pixel, con quattro componenti a 8 bit, senza subsampling, e colore CMYK dichiarato nel PDF e nel box colr. Il codestream usa progression order LRCP, un solo quality layer, MCT=0, cinque livelli di decomposizione, code-block 64 × 64 e trasformata 5/3 reversibile, con stile di quantizzazione 0, senza quantizzazione. Questi parametri descrivono la coppia allegata, non necessariamente le fotografie del documento iniziale.
Nella coppia definitiva sono presenti, tra gli altri, i seguenti marker:
SOC
SIZ
COD
QCD
SOT
SOD
EOC
Il marker di commento COM, presente in una versione precedente con l’indicazione del software di codifica, è stato rimosso da entrambi i PDF definitivi. Questa pulizia è comune ai due file e non altera i dati compressi dei campioni dell’immagine.
Nelle prove preliminari, convertire l’immagine in JPEG tradizionale mantenendo DeviceCMYK ne consentiva la visualizzazione in Anteprima. Questo esclude un’incapacità generale di mostrare immagini CMYK, ma non esclude un’interazione specifica tra CMYK, JPEG 2000 e il percorso di decodifica utilizzato.
I test svolti per isolare il problema
Le prove iniziali hanno incluso ricodifiche e conversioni, tra cui JPEG/DCT in CMYK e RGB, che consentivano di visualizzare le immagini. Sono verifiche utili per cercare alternative, ma cambiano più variabili e non bastano a individuare quale campo determini il comportamento.
Il confronto più controllato consiste invece nel mantenere identico il codestream JPEG 2000 e cambiare soltanto due byte della ftyp. Sulla coppia definitiva, usando PDFPage.thumbnail di PDFKit su macOS 26.6.2, build 25G83, abbiamo ottenuto:
BR="jpx ", CLi="jpx " + stesso codestream → PDFKit: pagina bianca

BR="jp2 ", CLi="jp2 " + stesso codestream → PDFKit: immagine visibile
Nei due container definitivi il box rreq (Reader Requirements) è assente in entrambe le varianti. La presenza o l’assenza di questo box non costituisce quindi una differenza tra GOOD e BAD. L’assenza di rreq è però rilevante quando si valuta la conformità JPX.
Il confronto byte per byte e le prove controllate permettono di associare il cambio di risultato alla ftyp in questi input. Non consentono, da soli, di ricostruire il percorso interno del decoder Apple.
Due PDF con due soli byte di differenza
La coppia definitiva è stata ridotta alle strutture necessarie per il test, rimuovendo i manifest C2PA e il commento del codestream. Il confronto riguarda i due PDF così ottenuti, ciascuno lungo 192.196 byte.
Entrambi:
- hanno una sola pagina;
- contengono una sola immagine;
- misurano 192.196 byte ciascuno;
- utilizzano
/JPXDecode; - utilizzano DeviceCMYK;
- contengono lo stesso codestream nel box
jp2c; - hanno identica struttura PDF.
Nell’intero PDF cambiano soltanto i byte agli offset 506 e 514, contando da zero (rispettivamente 0x1FA e 0x202). Sono gli offset 22 e 30 dall’inizio dello stream JPEG 2000: il primo appartiene al brand principale, il secondo all’unica voce della compatibility list. La versione minore resta zero. Lo spazio finale nei brand seguenti è parte del valore.
Nella variante GOOD, che il PDFKit verificato visualizza:
brand principale (BR):       "jp2 "
versione minore (MinV):      0
unica compatibilità (CLi):   "jp2 "
Nella variante BAD, in cui il PDFKit verificato non visualizza l’immagine:
brand principale (BR):       "jpx "
versione minore (MinV):      0
unica compatibilità (CLi):   "jpx "
Dal punto di vista binario, in ciascuna delle due posizioni cambia solamente:
0x32 "2"in:
0x78 "x"La verifica è stata eseguita direttamente con PDFKit, tramite PDFPage.thumbnail, su macOS 26.6.2, build 25G83. Questo test dell’API va distinto dalle osservazioni effettuate nell’app Anteprima sul documento originario:
- Variante JPX_BAD → PDFKit produce una pagina bianca.
- Variante JP2_GOOD → PDFKit visualizza l’immagine.
Con Poppler 25.06.0, invece, entrambi i PDF definitivi mostrano l’immagine: i rendering prodotti a 512 pixel sono identici pixel per pixel. I risultati dei diversi visualizzatori vanno sempre riferiti alle versioni e ai file effettivamente provati.
La variante JPX_BAD non mostra l’immagine nel test PDFKit descritto e la trovate a questo link: JPX_BAD.
La variante JP2_GOOD mostra invece l’immagine nello stesso test ma con la codifica corretta e la trovate a questo link: JP2_GOOD.
Con questi due file non stiamo confrontando due immagini ricodificate diversamente: il codestream JPEG 2000 è identico tra GOOD e BAD, ma i due pdf hanno hash differenti, perché due byte sono diversi. L’espressione “stesso file, stesso hash” riguarda invece l’esperimento successivo, nel quale un unico PDF viene aperto con renderer differenti.
Le impronte SHA-256 della coppia definitiva senza metadati descrittivi sono riportate qui sotto. Consentono di verificare che i file scaricati coincidano con quelli analizzati: una successiva elaborazione o l’aggiunta di metadati può modificarli e far venir meno il confronto di due soli byte.
GOOD — 192196 byte
2270aedfdbc143090f40bb6f063d216de638757b06926e5fd07a236a162f03a2

BAD — 192196 byte
b1a52bdfac9bf5a705207f1a358b237b7eca5dd63c8cbedcd3c67adc29469cfb
Il test aggiuntivo: quale dei due byte cambia il risultato?
Abbiamo provato tutte e quattro le combinazioni del brand principale e dell’unica voce della compatibility list, modificando copie in memoria e lasciando invariati gli altri byte e nel controllo effettuato con PDFKit su macOS 26.6.2 il risultato è stato il seguente:
BR       CLi      MEDIUM          Cane-Gatto
"jp2 "   "jp2 "   immagine        gatto
"jpx "   "jp2 "   immagine        gatto
"jp2 "   "jpx "   pagina bianca   cane
"jpx "   "jpx "   pagina bianca   cane
In questi input, sul PDFKit verificato, cambiare il solo byte della compatibility list è sufficiente; cambiare soltanto il brand principale non produce la differenza. La coppia distribuita differisce per due byte, ma due byte non sono il minimo necessario a ottenere il cambio di visualizzazione nell’esperimento controllato. Le combinazioni intermedie sono varianti diagnostiche, non una certificazione di conformità dei container.
Quindi JPX è un errore e causa un baco?
JPX è un formato standard, definito dalla Part 2 di JPEG 2000. Il testcase non dimostra che JPX sia inadatto ai PDF o che il renderer Apple non possa mai visualizzarlo, né che vi sia un baco nel sistema di rendering PDF: dimostra una differenza di comportamento su una specifica coppia di input.
La specifica PDF, nella sezione dedicata a JPXDecode, prevede anche lo spazio colore enumerato 12, CMYK, occorre però distinguere questo requisito dalla conformità del container: nella variante marchiata jp2 , il box colr dichiara proprio EnumCS 12, mentre la specifica JP2 prevede per gli spazi enumerati i valori 16, 17 e 18.
Nella variante marchiata jpx manca inoltre il box rreq, richiesto dalla struttura JPX descritta nella specifica T.801: il solo cambio di brand non rende quindi il container automaticamente conforme a JP2 o JPX. Possiamo quindi parlare di una differenza di rendering riprodotta e questi file, da soli, non costituiscono una prova definitiva di violazione dello standard da parte di Apple.
La causa precisa nel software richiederebbe ulteriori verifiche, l’analisi dell’implementazione o un riscontro del produttore. Un confronto tra file pienamente conformi sarebbe inoltre necessario per separare i problemi di conformità degli input dalle diverse strategie con cui i renderer li gestiscono.
Un PDF di test per “riconoscere” il renderer
Lo stesso principio enunciat osopra può essere usato per costruire un PDF dimostrativo con due messaggi sovrapposti: il testo visibile dipende da come viene gestita l’immagine superiore, non da una vera identificazione del software.
Nelle prove descritte, il documento mostra “You are using Apple rendering” quando resta visibile l’immagine sottostante e “You are NOT using Apple rendering” quando viene dipinta quella superiore. Le scritte sono etichette dimostrative: non certificano quale motore o sistema operativo sia in uso.
Il meccanismo non richiede JavaScript, lettura dello User-Agent o riconoscimento del sistema operativo: sfrutta la diversa rappresentazione dell’oggetto JPEG 2000. Qualunque renderer con lo stesso comportamento potrebbe produrre lo stesso messaggio.
È una dimostrazione interessante di un principio più generale della document analysis: lo stesso insieme di byte può produrre rappresentazioni visive differenti a seconda dell’implementazione utilizzata per interpretarlo.
Le due versioni linguistiche del PDF dimostrativo sono disponibili qui di seguito, qui la versione italiana, mentre qui quella in inglese.
Come evitare il problema creando un PDF
Chi produce PDF destinati a una distribuzione ampia dovrebbe privilegiare strutture conformi e verificate con più renderer. Il formato va scelto in funzione dell’immagine, dello spazio colore, della qualità richiesta e delle applicazioni destinatarie.
Pur non trattandosi di un bug, se si mantiene JPEG 2000, bisogna generare un container conforme alle funzionalità e al colore effettivamente utilizzati: JP2 non si ottiene semplicemente rinominando il brand di un’immagine CMYK. Quando compatibile con le esigenze del documento, JPEG con /DCTDecode è un’alternativa da valutare e verificare.
La scelta deve distinguere codec, container e filtro PDF. Un’estensione del nome del file o il supporto dichiarato di un formato non sostituiscono la verifica del PDF finale.
In un workflow editoriale è opportuno verificare cosa accade dopo l’esportazione dal programma d’impaginazione, ad esempio provando ad aprire il pdf con diversi software e sistemi operativi: nel documento inizialmente esaminato, che ha dato il via alla presente ricerca, i metadati indicavano Adobe InDesign come Creator e un servizio successivo come Producer, campi che rappresentano indizi sulla lavorazione, non una prova sufficiente per attribuire la modifica delle immagini a uno specifico software.
Gli strumenti per l’analisi forense dei PDF e del rendering
Per una prima verifica è utile confrontare lo stesso documento con renderer indipendenti. Il fatto che Anteprima, o qualunque altro singolo visualizzatore, non mostri un’immagine non dimostra che i suoi dati siano assenti dal PDF.
Nel controllo della coppia definitiva abbiamo confrontato PDFKit e Poppler, mentre ullteriori applicazioni, come Acrobat o Foxit, possono ampliare la matrice di prova, purché si registrino versioni e risultati senza dedurli dal solo sistema operativo.
Per JPEG 2000, OpenJPEG offre strumenti per esaminare codestream e parametri di codifica. Ad esempio, la documentazione dei parametri del codestream distingue l’identificatore della trasformata 9/7 irreversibile da quello della 5/3 reversibile. Il successo di una decodifica non equivale però alla validazione completa del container.
Per il confronto binario occorre controllare sia gli stream estratti sia l’intero PDF. Anche i metadati e gli aggiornamenti incrementali possono introdurre differenze: nelle versioni precedenti della coppia, i manifest C2PA rendevano inesatta l’affermazione “due soli byte nell’intero file”.
Per l’analisi forense del pdf a basso livello, però, spesso la cosa più utile rimane esaminare direttamente:
/Image
/Filter /JPXDecode
/ColorSpace
/SMask
e quindi estrarre lo stream, distinguere i box presenti da quelli assenti e analizzarne i campi. Tra i box pertinenti rientrano:
jP
ftyp
rreq
jp2h
colr
jp2c
L’analisi informatica forense del PDF va completata con i marker del codestream, le risorse della pagina, l’ordine di disegno e gli eventuali gruppi di trasparenza. rreq, per esempio, è pertinente alla conformità JPX ma non è presente nella coppia definitiva.
Oltre il riquadro grigio: due immagini nello stesso PDF
Nel documento iniziale il sintomo era una fotografia non visualizzata, con un’area grigia al suo posto. Nel testcase a immagine singola, il risultato verificato tramite PDFKit è invece una pagina bianca. L’esperimento successivo rende la differenza ancora più evidente.
La differenza di rendering può essere sfruttata anche per ottenere un risultato molto più evidente, cioè fare in modo che lo stesso PDF mostri due immagini completamente diverse a seconda del renderer utilizzato.
Abbiamo realizzato un PDF contenente le fotografie di un cane e di un gatto. Sul campione analizzato abbiamo riprodotto questi risultati:
- con PDFKit, tramite
PDFPage.thumbnail, su macOS 26.6.2 compare il cane; - con Poppler 25.06.0 compare il gatto.
Il meccanismo consiste in due immagini sovrapposte con codifiche differenti. Nella struttura analizzata non ci sono JavaScript o istruzioni per selezionare il contenuto in base al viewer. I dati pertinenti all’esperimento sono:
Pagina:               700 x 700 punti
Image XObject:        2
Immagine sottostante: cane, JPEG /DCTDecode, RGB
Immagine superiore:   gatto, JPEG 2000 /JPXDecode, CMYK
Brand del gatto:      "jpx "
Ordine di disegno:    cane, poi gatto
Potete scaricare il “PDF di Schrödinger” dal seguente link: il nome “PDF di Schrodinger” è una metafora, perché entrambe le immagini sono già contemporaneamente nel file e il risultato dipende dal rendering, non da una modifica del documento durante l’apertura, il pdf quindi contiene un gatto e un cane contemporaneamente.
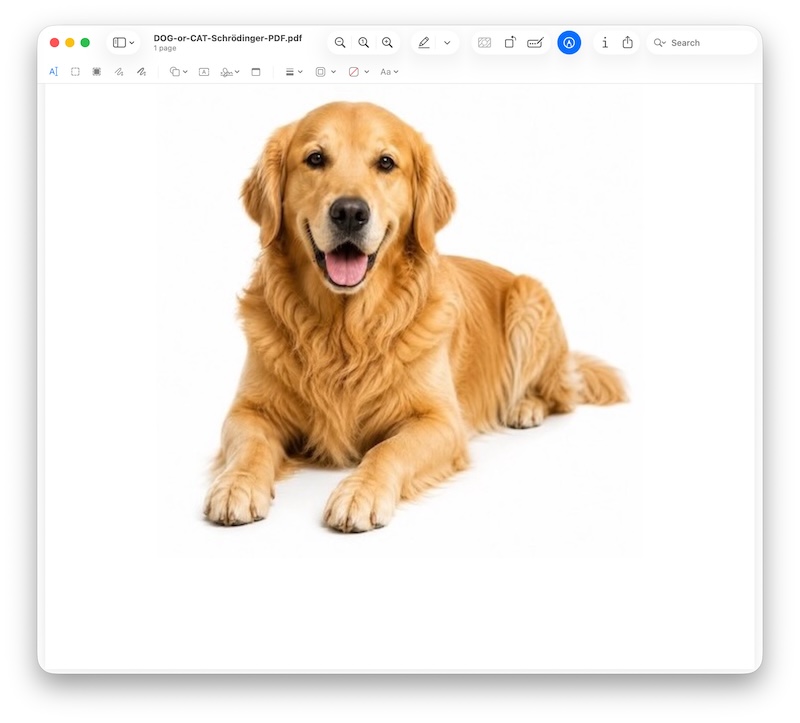
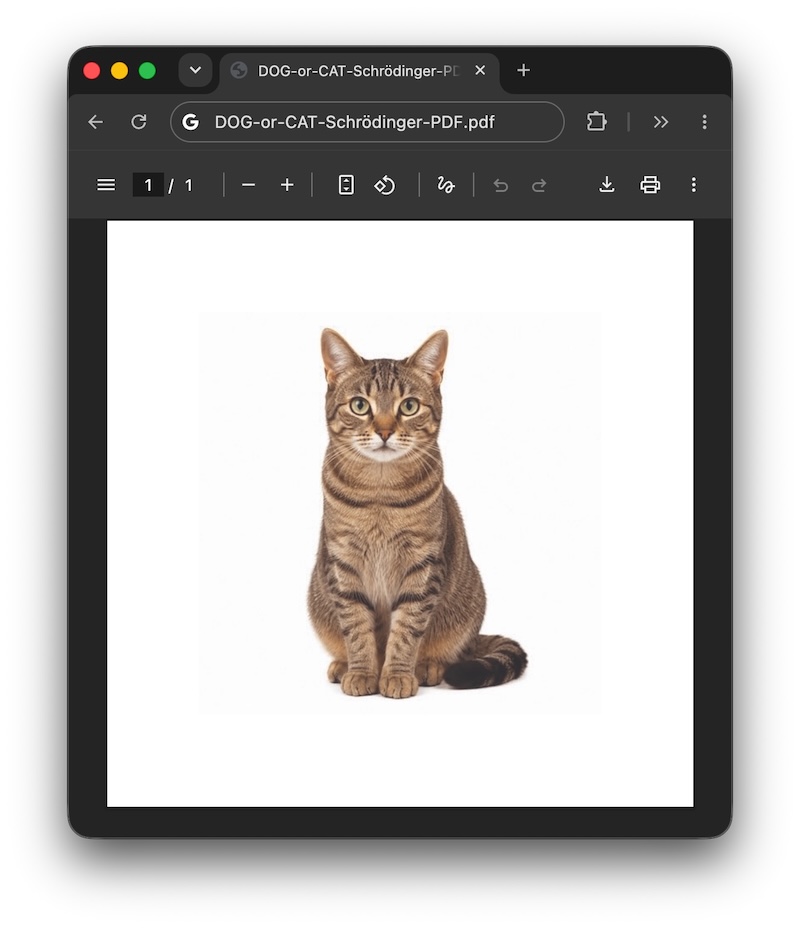
Le immagini seguenti documentano il confronto descritto tra Anteprima e Google Chrome su macOS. Il principio dell’esperimento è aprire lo stesso file con applicazioni differenti: l’identità dei file va verificata sui byte o tramite hash, non desunta dal solo nome mostrato nelle schermate.
Il confronto fotografico comprende anche uno smartphone Android, a sinistra, e un iPhone, a destra: nelle applicazioni utilizzate per questa prova compaiono rispettivamente il gatto e il cane. La fotografia documenta il risultato visivo; da sola non dimostra l’identità binaria delle copie aperte né permette di generalizzare a tutte le applicazioni dei due sistemi.
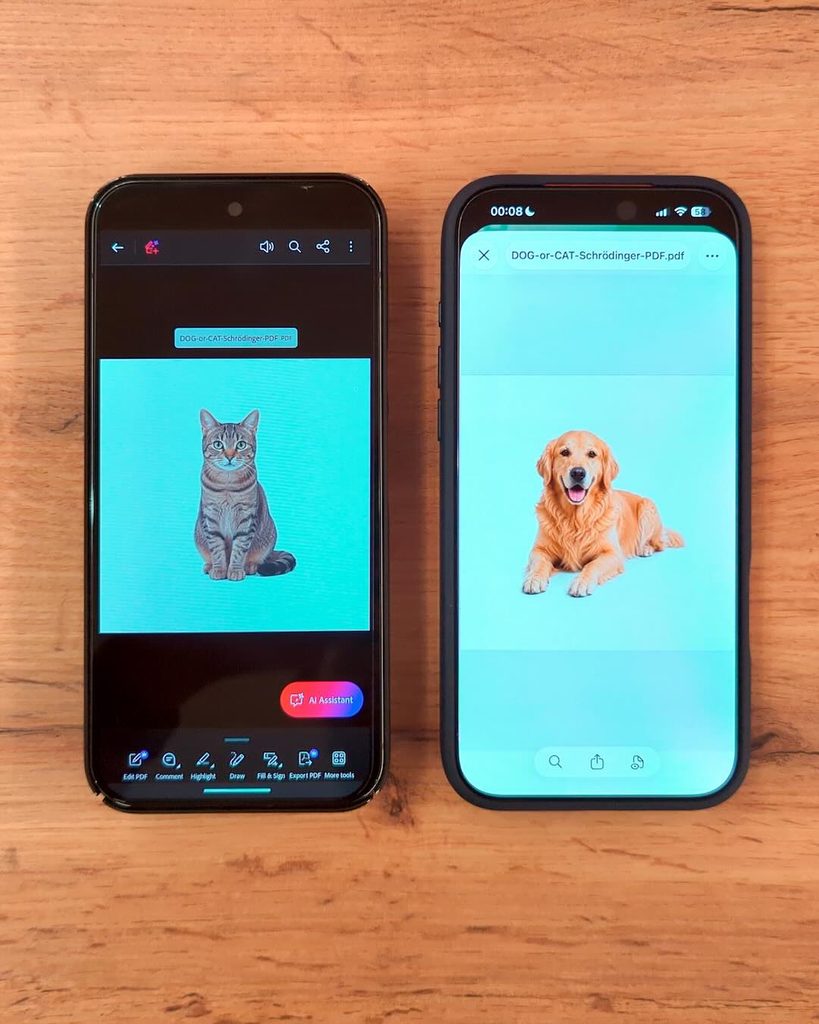
Questi esempi vanno letti come osservazioni sugli ambienti provati. Windows, Android e iOS sono sistemi operativi, non renderer: per riprodurre il risultato occorre specificare anche l’applicazione e la sua versione.
Come funziona l’esperimento
Il principio è quello già utilizzato nel PDF dimostrativo contenente i messaggi “You are using Apple rendering” e “You are NOT using Apple rendering”, ma applicato questa volta a contenuti fotografici.
Il documento contiene entrambe le immagini: il cane è un JPEG RGB con filtro /DCTDecode, mentre il gatto è un’immagine JPEG 2000 CMYK con filtro /JPXDecode e brand jpx . Un Form XObject, inserito in un gruppo di trasparenza isolato, disegna prima il cane e poi il gatto sulla stessa area. Quando il gatto viene dipinto, copre il cane; quando non viene dipinto, resta visibile il cane sottostante.
Il comportamento osservato si può quindi descrivere così:
- Il gatto superiore non viene dipinto → resta visibile il CANE.
- Il gatto superiore viene dipinto → copre il cane e compare il GATTO.
Il PDF non “decide” quale applicazione lo sta aprendo. Non contiene una condizione “se Apple mostra A, altrimenti mostra B”: il risultato dipende dall’esecuzione delle istruzioni di disegno da parte del renderer. I byte della ftyp riguardano il container del gatto; non trasformano il codestream di un animale in quello dell’altro.
Il problema non è più solo un’immagine che non si vede
Nel documento che ha originato la presente analisi la differenza della codifica poteva essere interpretata semplicemente come una fotografia non visualizzata. Il testcase Cane-Gatto rende invece evidente che l’omissione di un’immagine può anche lasciare visibile un contenuto alternativo già presente sotto di essa e quindi mostrare due immagini diverse con lo stesso PDF.
Il testcase con cane e gatto dimostra quindi un concetto più generale: una differenza nell’interpretazione o nel rendering degli oggetti di un PDF con stesso valore hash può determinare rappresentazioni visive sostanzialmente differenti dello stesso documento.
Due persone possono quindi aprire copie dello stesso file, verificarne l’hash e vedere contenuti differenti utilizzando software diversi. Questo è rilevante anche quando il documento viene esaminato prima di una firma: l’identità dei dati non garantisce l’identità di ciò che viene mostrato. Il testcase non costituisce però una prova del comportamento di uno specifico workflow di firma, che richiede verifiche separate.
Non è un sistema universale per riconoscere il viewer. Il risultato potrebbe cambiare con versioni differenti delle applicazioni o delle librerie, e lo stesso comportamento potrebbe essere condiviso da renderer diversi.
L’interesse nell’ambito informatico forense
Dal punto di vista della digital forensics, il confronto degli hash crittografici è uno strumento per verificare l’identità delle copie. Non è una verifica dell’equivalenza dei rendering: questa richiede osservazioni e confronti ulteriori.
In presenza di anomalie o contestazioni è utile documentare hash del file, sistema operativo, applicazione, versione, modalità di apertura e, quando noto, motore di rendering. È altrettanto utile conservare l’originale, distinguere le copie di lavoro e confrontare il risultato con un’implementazione indipendente.
Il cane e il gatto rendono visibile un limite pratico: l’esame del solo risultato a schermo non esaurisce l’analisi del documento.
Conclusioni
Da un documento editoriale con immagini non visualizzate siamo arrivati a una coppia controllata: una pagina, una sola immagine, stessa dimensione e due soli byte differenti nella ftyp, con codestream identico. Il PDFKit verificato mostra l’immagine nella variante GOOD e una pagina bianca nella variante BAD.
Poppler 25.06.0 produce invece lo stesso rendering per entrambe. Il test sulle quattro combinazioni dei campi ha mostrato inoltre che, nell’ambiente PDFKit verificato, basta il cambiamento del solo byte della compatibility list per modificare il risultato. Questo dettaglio restringe l’osservazione sperimentale, senza identificare da solo la causa nel software.
La differenza è riproducibile, ma i limiti di conformità dei container impediscono di presentare la coppia come prova definitiva di una violazione normativa di Apple. Per chi produce o analizza PDF, il criterio operativo è usare strutture conformi, conservare gli originali e verificare il documento finale con più renderer, senza trattare il cambio di brand come una riparazione universale.
In questa coppia, tra un PDF che mostra l’immagine e uno che sembra averla persa ci sono letteralmente due byte. Nel PDF Cane-Gatto non cambia neppure un byte tra un’apertura e l’altra: cambia il software che lo interpreta.


