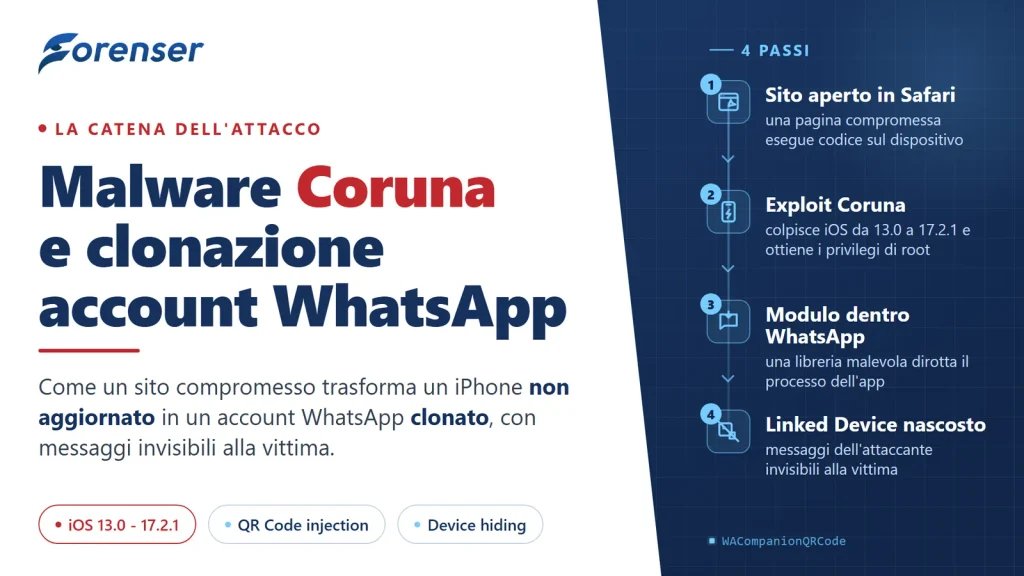
Nel corso degli ultimi mesi, in Italia e in alcuni Paesi esteri, è stato rilevato un fenomeno di particolare interesse. Numerosi account WhatsApp, installati sistematicamente su dispositivi con versioni di iOS non più aggiornate, presentano indizi di compromissione e, in particolare, di clonazione. Sembrano infatti essere stati utilizzati da soggetti non autorizzati per inviare messaggi all’insaputa del legittimo titolare del dispositivo. In particolare, sono stati osservati i seguenti elementi:
I dispositivi compromessi erano tutti iPhone con una versione obsoleta di iOS, come la 16.x;
La compromissione del dispositivo portava, apparentemente, alla clonazione della sessione di WhatsApp da parte del threat actor, che la utilizzava per inviare richieste di denaro ai contatti della vittima;
Nessun dispositivo è stato identificato all’interno della lista dei Linked Device di WhatsApp, il che faceva pensare che non si trattasse di un semplice “ghost pairing”;
I messaggi inviati dagli attaccanti non erano visibili alla vittima, che di conseguenza non era a conoscenza delle richieste di denaro;
L’unico modo per tornare a una situazione normale sembrerebbe ripristinare il dispositivo ai dati di fabbrica, aggiornarlo e reinstallare WhatsApp. La reinstallazione di WhatsApp porta al ripristino della sessione (e logout della sessione clonata), mentre il ripristino e l’aggiornamento di iOS dovrebbero eliminare definitivamente la minaccia e l’eventuale persistenza del malware.
L’unico comune denominatore era, a quanto pare, l’utilizzo di una versione obsoleta del sistema operativo, sempre inferiore alla 18; inoltre, le prime ricerche sembravano associare l’attacco a una vulnerabilità nota, con diversi PoC disponibili online: la CVE-2025-43300, legata a una corruzione di memoria dovuta a un bug del framework ImageIO.
Questo dettaglio ci ha portati ad approfondire le analisi sulle copie forensi complete (full file system) a nostra disposizione, ottenendo un risultato diverso e molto curioso: siamo riusciti non solo a ricostruire l’intera catena che ha portato alla compromissione del dispositivo, ma anche ad analizzare il malware stesso. Prima di entrare nei dettagli dell’analisi, facciamo una premessa sul malware in questione: Coruna.
Coruna
Nel panorama dei malware che colpiscono smartphone, Coruna rappresenta, insieme a Darksword, uno dei framework di attacco (exploit kit) più complessi e sofisticati mai individuati ai danni dell’ecosistema Apple. Identificato e reso pubblico dai ricercatori del Threat Intelligence Group di Google – con analisi parallele condotte da società di sicurezza come iVerify e Kaspersky – questo potente insieme di strumenti agenti come spyware, pare essere stato inizialmente sviluppato nell’ambito della sorveglianza statale, prima di finire nelle mani della criminalità informatica.
A livello operativo, Coruna si attiva quando un utente visita un sito web compromesso o contraffatto tramite Safari: sfruttando una serie di falle concatenate nel browser e nel sistema operativo, il malware riesce a superare le protezioni di iOS per accedere al dispositivo ed estrarre informazioni riservate, tra cui credenziali e dati finanziari. Il raggio d’azione della minaccia rimane tuttavia limitato ai soli dispositivi che eseguono versioni obsolete di iOS (da iOS 13 a iOS 17.2.1) e non ha alcun effetto sui sistemi operativi aggiornati.
Secondo le analisi degli esperti di sicurezza di Google, la vulnerabilità all’exploit kit Coruna non dipende da un singolo modello di iPhone, ma dalla versione del sistema operativo iOS installata sul dispositivo.
Ad oggi sembra che gli smartphone colpiti abbiano le seguenti caratteristiche:
Versioni di iOS colpite: Da iOS 13.0 (rilasciato nel 2019) fino a iOS 17.2.1 (rilasciato a fine 2023).
Modelli interessati: Tutti gli iPhone in grado di eseguire tali versioni di iOS, inclusi:
Modelli più datati: iPhone 6s, 7, 8, 8 Plus e iPhone X (fermi a versioni precedenti come iOS 15 o iOS 16).
Modelli recenti: Dai modelli con chip A12 (iPhone XS, XR) fino agli iPhone 11, 12, 13, 14 e 15 (con chip A17 Pro), a patto che non venissero aggiornati oltre iOS 17.2.1.
Tornando al nostro caso, uno dei componenti presi di mira dal malware è proprio l’applicazione WhatsApp.
Analisi dei dispositivi infetti
In una prima fase, l’analisi si è concentrata sugli eventi che hanno preceduto la truffa, su cosa fosse successo sul dispositivo e su quali nuovi artefatti fossero stati creati dal sistema stesso, ottenendo una serie di risultati molto interessanti.
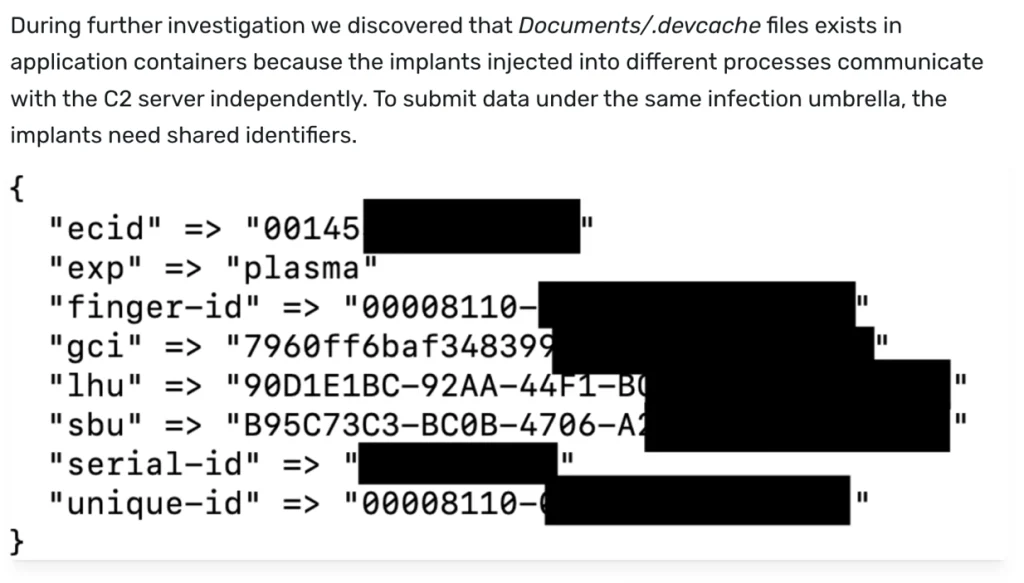
Il primo è stato l’individuazione di un IoC reso pubblico recentemente da iVerify, ovvero il file .devcache. Come riportato nel loro blog, l’infezione da parte del malware Coruna portava alla creazione di un nuovo file all’interno della cartella Documents del processo stesso, contenente informazioni relative al dispositivo.
Estratto articolo di iVerify – “https://www.iverify.com/blog/proliferation-of-coruna-and-darksword”
Oltre al file .devcache, sono stati rinvenuti ulteriori IoC, come ad esempio un archivio 7z contenuto nella cartella “/private/var/root/Library/Caches/com.apple.WebKit.WebC/”, compatibile con quanto riportato nelle analisi di Google relativamente all’utilizzo di archivi 7z cifrati per il delivery del malware stesso.
Questi file sono stati rinvenuti su tutte le copie forensi da noi analizzate e correlate al caso WhatsApp, il che ci ha spinti a concentrare le ricerche su Coruna.
Pertanto, alla luce di questa nuova ipotesi, abbiamo recuperato alcuni sample del malware e, attraverso processi di reverse engineering, abbiamo ottenuto il modulo completo relativo a WhatsApp utilizzato da Coruna, nonché i vettori da esso utilizzati per infettare i dispositivi.
L’infezione del dispositivo avviene mediante la visita di un URL malevolo. La pagina visitata dal dispositivo della vittima contiene dei file JavaScript che vengono sfruttati dall’attaccante per compromettere il browser e ottenere l’esecuzione di codice sul dispositivo della vittima. In seguito all’esecuzione del codice, l’attaccante ottiene i privilegi massimi sul device (agendo come “root” user) sfruttando ulteriori vulnerabilità del sistema operativo, acquisendo così il pieno controllo dell’intero dispositivo e l’accesso a ogni singolo dato.
Una volta ottenuto l’accesso completo, l’attaccante procede con l’installazione del modulo WhatsApp.
In questo caso non stiamo parlando di una semplice nuova applicazione, ma di qualcosa di “nascosto” e normalmente non visibile all’utente finale, ovvero un processo in esecuzione con privilegi di root che effettua l’hijacking (dirottamento) all’interno del processo di WhatsApp. In sintesi, Coruna carica una libreria malevola all’interno del processo di WhatsApp, manipolandone l’esecuzione.
Grazie alle tecniche di reverse engineering abbiamo portato alla luce come effettivamente agisce tale modulo, una volta inseritosi nel processo di WhatsApp.
Creazione Linked Device (QR Code Injection)
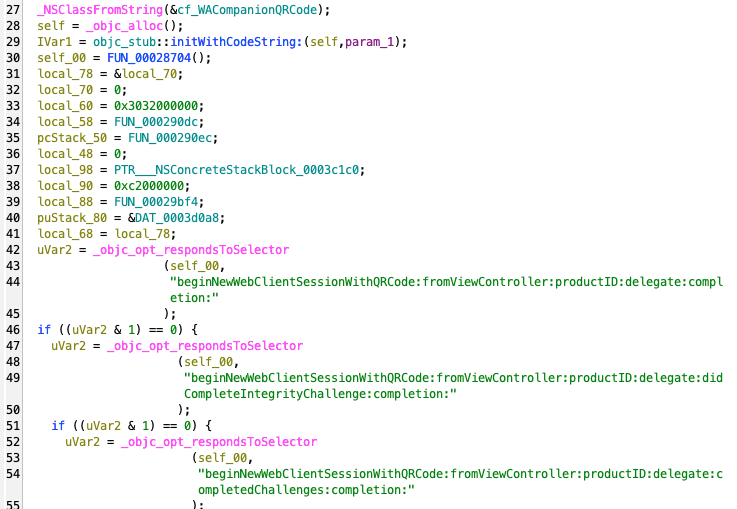
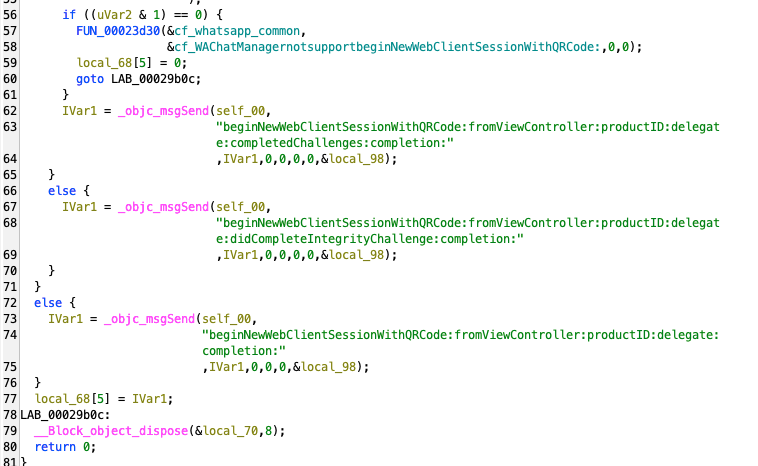
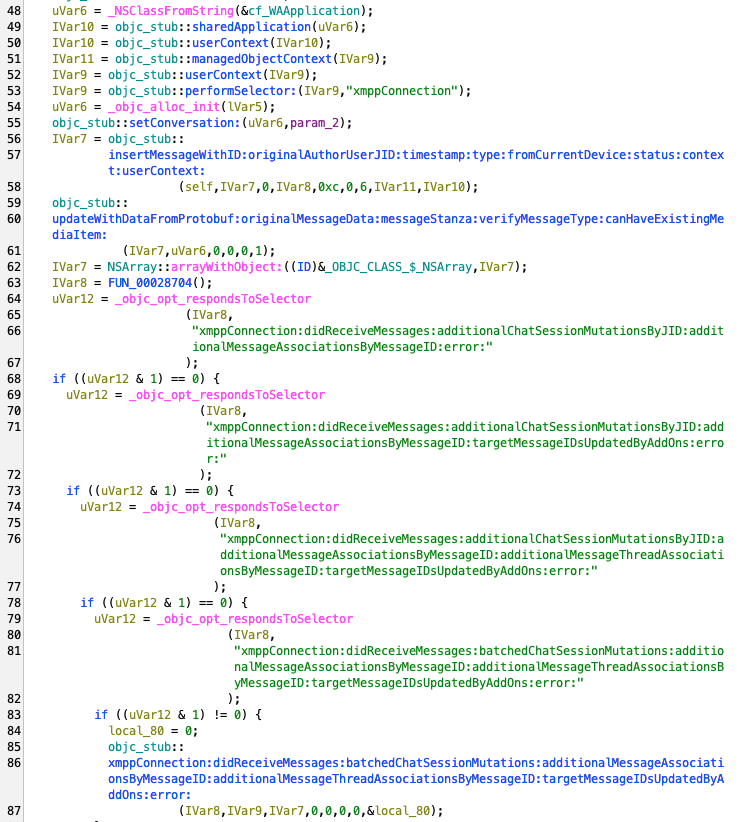
Questa sembra essere la funzionalità più interessante del malware. All’interno del modulo sono state trovate delle funzionalità che si agganciano (hooking) alle funzioni utilizzate dall’applicazione per aggiungere un nuovo Linked Device tramite QR Code. In sostanza, il malware utilizzava le funzionalità già presenti nel processo di WhatsApp per aggiungere un nuovo dispositivo.
Estratto del codice reversato relativo al modulo di WhatsApp e alla gestione degli hooking relativi al QR Code
Estratto del codice reversato relativo al modulo di WhatsApp e alla gestione degli hooking relativi al QR Code
Per farlo, l’attaccante inviava dal C2 (server malevolo utilizzato per controllare e lanciare comandi sul dispositivo infetto) un nuovo QR Code (ad esempio quello visualizzato sul browser dell’attaccante) da aggiungere tra i dispositivi. Tale funzionalità avvia direttamente la procedura di aggiunta, senza bisogno di aprire le impostazioni di WhatsApp e scansionare il QR Code: in questo modo è possibile aggiungere un nuovo dispositivo come Linked Device anche quando il telefono non è in uso. Questa scoperta ha chiaramente cambiato lo scenario, in quanto l’attaccante sembra effettivamente utilizzare la tecnica del Linked Device (operazione che nel normale funzionamento di WhatsApp è legittima) per controllare l’account della vittima.
Ora una domanda sorge spontanea: come mai le vittime hanno sempre affermato di non aver mai visto un nuovo Linked Device nella lista? Anche in questo caso, la risposta l’abbiamo trovata analizzando il malware.
Device Hiding
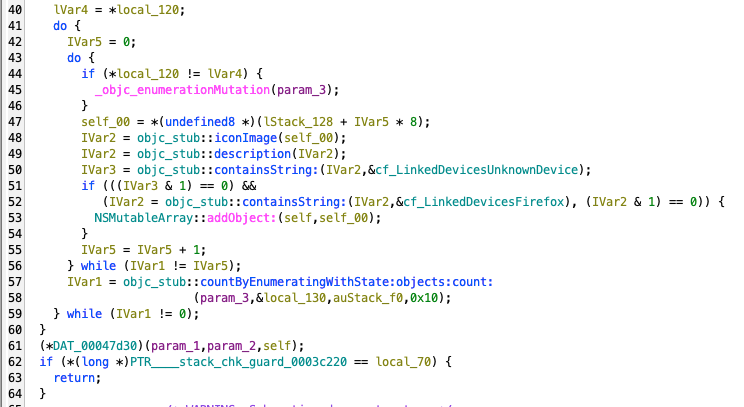
Durante l’analisi abbiamo identificato una funzionalità che, tramite tecniche di hooking (ovvero l’intercettazione delle chiamate effettuate dal processo in fase di esecuzione), controlla quali dispositivi vengono aggiunti alla lista dei Linked Device e, se compaiono dispositivi identificati come LinkedDevicesFirefox o LinkedDevicesUnknownDevice, li rimuove dalla lista.
Riferimenti sulla ricerca del Linked Device da parte del modulo di WhatsApp
Ciò è compatibile con quanto affermato dalle vittime, che non riuscivano a vedere alcun nuovo dispositivo sospetto tra i Linked Device poiché questi venivano semplicemente rimossi dalla lista prima della visualizzazione.
Eliminazione dei messaggi in uscita
Un’altra caratteristica comune riportata dalle vittime è l’impossibilità di vedere i messaggi inviati dagli attaccanti. Infatti, quando l’attaccante inviava un nuovo messaggio di richiesta di denaro, le vittime non vedevano nulla.
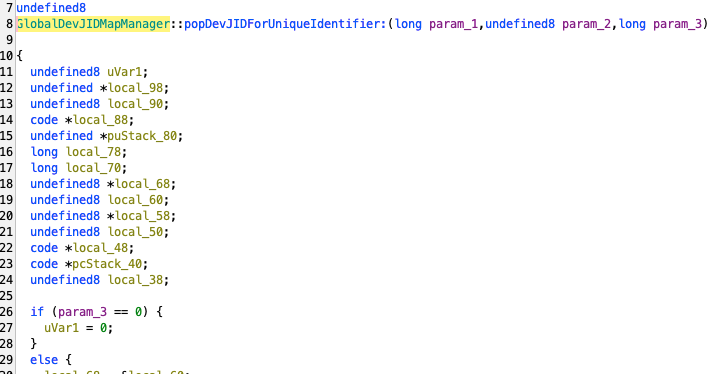
Anche questo comportamento è stato riscontrato nel modulo caricato dagli attaccanti: nel codice sono presenti degli hook che intercettano tutti i messaggi inviati dal JID (l’identificativo utilizzato da WhatsApp per identificare univocamente un dispositivo nell’applicazione) del Linked Device dell’attaccante e li rimuovono.
Porzione di codice coinvolto nella rimozione del messaggio di un relativo JID
Porzione di codice coinvolto nella rimozione del messaggio di un relativo JID
In questo modo, quando l’attaccante invia un nuovo messaggio, questo viene soppresso se corrispondente all’identificativo del dispositivo dell’attaccante.
Oltre alle funzionalità appena descritte sono state identificate anche le seguenti peculiarità:
Intercettazione di tutti i tipi di messaggio e caricamento sul server dell’attaccante. In questo caso la cifratura end-to-end (E2EE) non ha effetto, in quanto l’intercettazione avviene direttamente sul dispositivo DOPO che i messaggi sono stati decifrati;
Esfiltrazione delle identità, ovvero numeri di telefono, avatar e identità dei contatti;
Fingerprinting del dispositivo;
Bypass SSL Pinning, tecnica solitamente utilizzata per ottenere in chiaro tutto il traffico dell’applicazione, che normalmente è cifrato;
Funzionalità di persistenza.
Infine, è importante considerare, vista la natura del malware Coruna, che questo è anche in grado di esfiltrare informazioni relative ad altre applicazioni, come ad esempio Telegram. Infatti, in alcuni exploit è stato rilevato codice compatibile con l’esfiltrazione di dati di sistema e di altre app.
Per preservare la sicurezza dei dati contenuti nel dispositivo valgono sempre le stesse regole di sicurezza di cui si è parlato in questi mesi, tra cui, su tutte, mantenere i device costantemente aggiornati.
Nell’informatica forense, la PDF forensics si occupa dell’acquisizione e dell’analisi tecnica dei documenti PDF: struttura interna, immagini, metadati, revisioni, possibili manipolazioni e firme digitali. Anche l’esame delle firme rappresentate graficamente richiede di distinguere ciò che il documento contiene da ciò che viene mostrato sullo schermo.
Ci sono casi nei quali questa analisi diventa più complessa a causa di differenze di interpretazione o di rendering, dovute alla struttura del documento, al software utilizzato o alla loro interazione. Tali differenze possono anche essere sfruttate intenzionalmente da chi costruisce il PDF.
Ci siamo imbattuti in un PDF nel quale alcune immagini non comparivano in Anteprima (Preview) su macOS, pur essendo visibili con altri software. Al posto di alcune fotografie apparivano riquadri grigi; lo stesso documento, aperto con altri visualizzatori, mostrava invece le immagini.
L’indagine è partita dalle immagini della copertina: prima di considerarle mancanti o danneggiate, abbiamo verificato che fossero effettivamente presenti negli oggetti del PDF.
Attraverso una serie di test sempre più ridotti è stato possibile circoscrivere una differenza di comportamento alla gestione di particolari immagini JPEG 2000 con campi della File Type Box che dichiarano il formato JPX. Questa dichiarazione va distinta dalla piena conformità del container allo standard.
Il risultato è particolarmente interessante: abbiamo costruito due PDF che differiscono esclusivamente per due byte nell’intero file, con lo stesso codestream JPEG 2000. Nel test effettuato con PDFKit su macOS, una variante mostra l’immagine e l’altra produce una pagina bianca.
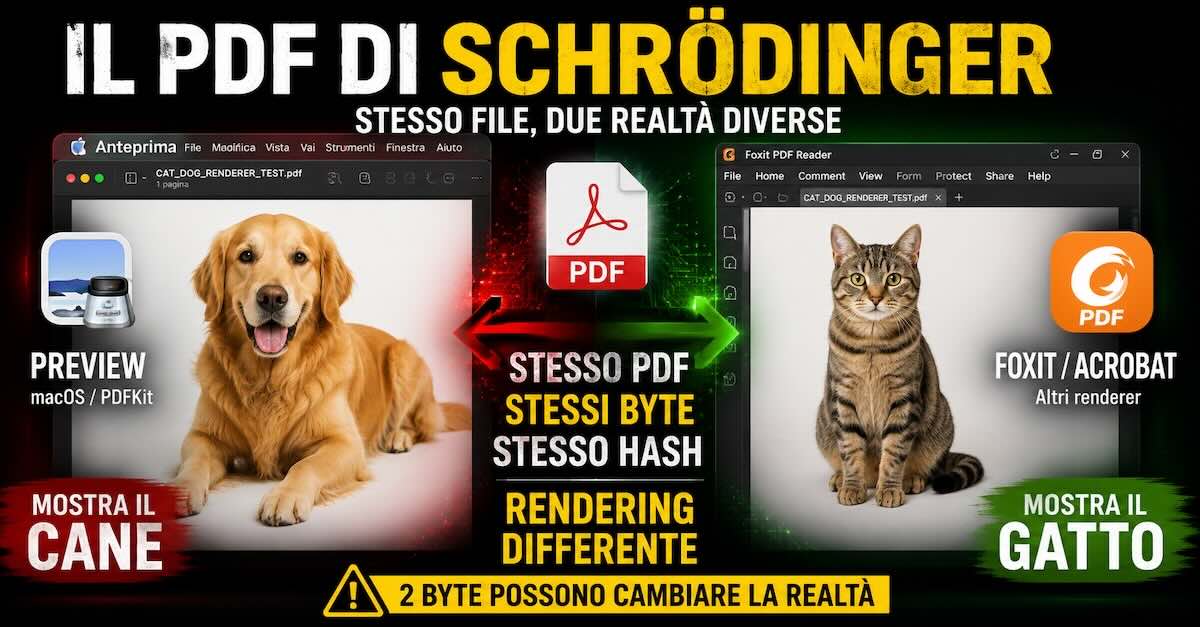
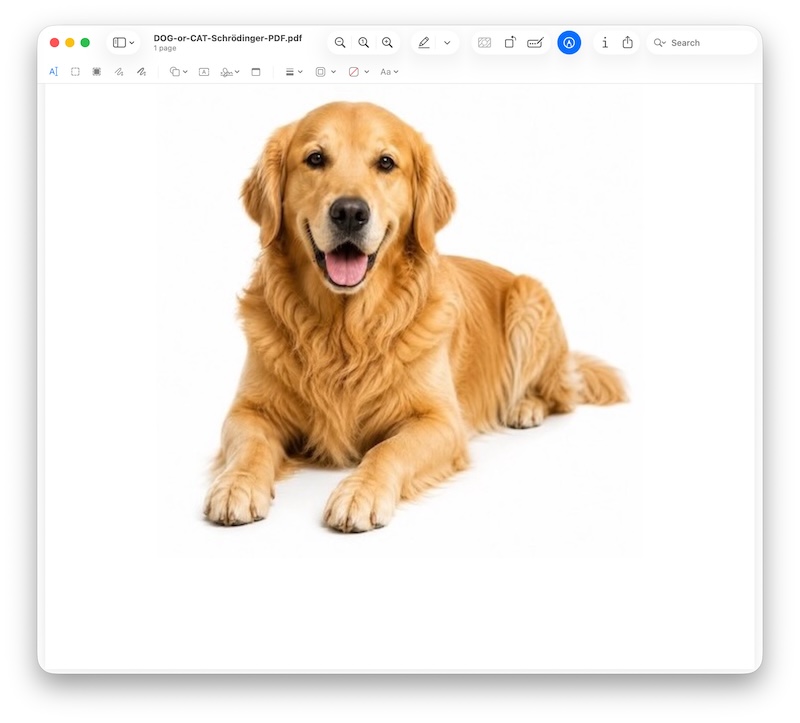
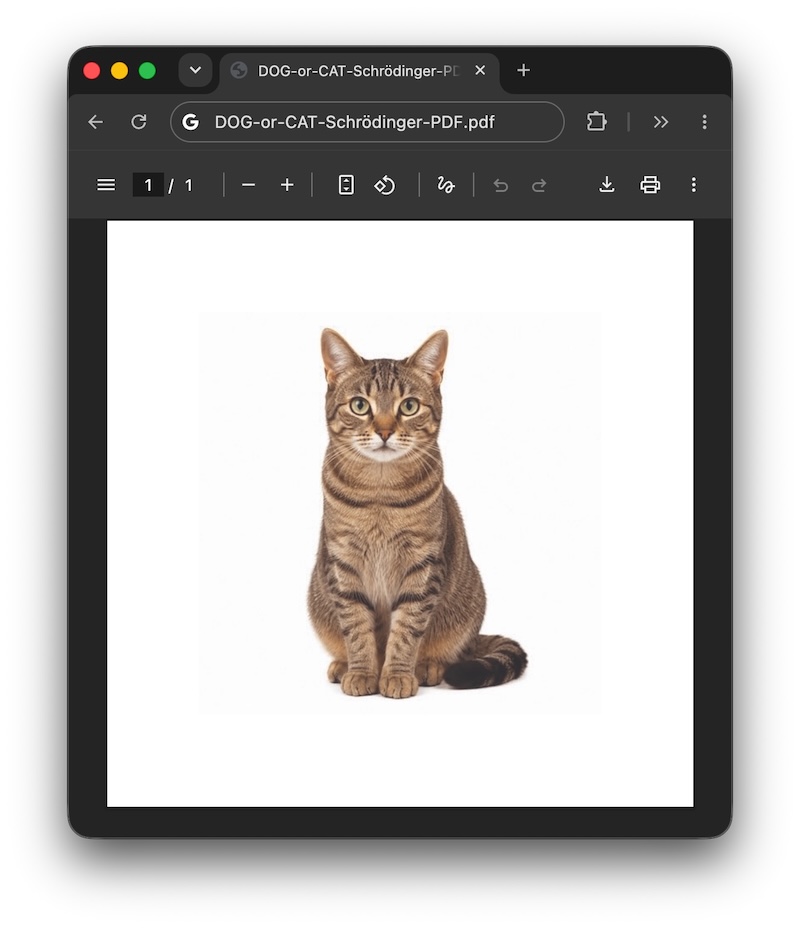
Abbiamo poi sfruttato la differenza di rendering per costruire un secondo esperimento: un solo PDF che mostra un cane con un renderer e un gatto con un altro. Il file non cambia; cambia la sua rappresentazione visiva.
La struttura del PDF e le immagini contenute
Per capire il problema bisogna innanzitutto distinguere il documento PDF dal modo in cui viene visualizzato.
Un PDF è un contenitore strutturato che può includere testo, font, grafica vettoriale, immagini raster, trasparenze, profili colore, maschere, livelli e numerosi altri oggetti. Quando apriamo il documento non stiamo necessariamente vedendo qualcosa di già “disegnato”: è il renderer PDF a interpretare quegli oggetti e a trasformarli nei pixel mostrati sul display.
Applicazioni differenti possono utilizzare motori differenti, mentre applicazioni diverse possono anche condividere lo stesso motore. Anteprima e altre applicazioni Apple utilizzano le tecnologie PDF del sistema; altri visualizzatori impiegano implementazioni differenti. Anche nel browser il risultato dipende dal componente che apre il PDF: per descrivere una prova servono quindi applicazione, versione e modalità di apertura, oltre al sistema operativo.
Un documento leggibile da un renderer può dunque evidenziare un limite, un errore o una diversa gestione dell’input in un altro. Il fatto che un software mostri l’immagine, da solo, non dimostra però che l’intero documento sia conforme alle specifiche.
Le immagini “scomparse” erano ancora dentro il PDF
Nel documento originario, gli Image XObject delle fotografie erano presenti, con dimensioni e stream apparentemente coerenti. Altri visualizzatori riuscivano a decodificarli e a mostrarli: l’assenza sullo schermo non corrispondeva all’assenza dei dati nel PDF.
Le sei immagini problematiche della copertina condividevano una caratteristica:
JPEG 2000 + CMYK + filtro PDF /JPXDecode.
Il filtro /JPXDecode, introdotto con PDF 1.5, è il meccanismo previsto per decodificare immagini JPEG 2000. Il suo nome non significa che ogni stream debba avere il brand jpx : lo stesso filtro è usato anche per immagini con container JP2. La specifica disciplina inoltre il rapporto tra le informazioni colore interne all’immagine e quelle dell’Image XObject.
La presenza di /JPXDecode, quindi, non costituisce di per sé un errore.
I formati JP2 e JPX
JPEG 2000 comprende una famiglia di specifiche. La Part 1 definisce il sistema di codifica principale e il formato JP2; la Part 2 introduce estensioni alla codifica e il formato JPX, con funzionalità aggiuntive per la descrizione del colore, più codestream e la composizione delle immagini. È essenziale distinguere il codestream compresso dal container che lo racchiude.
Un container JP2 è organizzato in box. Lo schema seguente descrive i quattro box di primo livello presenti anche negli stream del testcase; non è una descrizione completa dei requisiti di un JPX conforme. Un codestream JPEG 2000 privo di container, invece, non presenta questa struttura a box:
La File Type Box (ftyp) contiene un brand principale, un valore di versione minore e una lista di compatibilità. Nell’analisi abbiamo confrontato la dichiarazione:
brand = "jpx "
con:
brand = "jp2 "
Analizzare il codestream JPEG 2000
Per distinguere le proprietà delle immagini da quelle del container abbiamo esaminato i marker del codestream. È importante separare le immagini del documento originario dal testcase sintetico distribuito qui: non sono lo stesso insieme di dati.
Nei due PDF definitivi del testcase, l’immagine è di 512 × 512 pixel, con quattro componenti a 8 bit, senza subsampling, e colore CMYK dichiarato nel PDF e nel box colr. Il codestream usa progression order LRCP, un solo quality layer, MCT=0, cinque livelli di decomposizione, code-block 64 × 64 e trasformata 5/3 reversibile, con stile di quantizzazione 0, senza quantizzazione. Questi parametri descrivono la coppia allegata, non necessariamente le fotografie del documento iniziale.
Nella coppia definitiva sono presenti, tra gli altri, i seguenti marker:
SOC
SIZ
COD
QCD
SOT
SOD
EOC
Il marker di commento COM, presente in una versione precedente con l’indicazione del software di codifica, è stato rimosso da entrambi i PDF definitivi. Questa pulizia è comune ai due file e non altera i dati compressi dei campioni dell’immagine.
Nelle prove preliminari, convertire l’immagine in JPEG tradizionale mantenendo DeviceCMYK ne consentiva la visualizzazione in Anteprima. Questo esclude un’incapacità generale di mostrare immagini CMYK, ma non esclude un’interazione specifica tra CMYK, JPEG 2000 e il percorso di decodifica utilizzato.
I test svolti per isolare il problema
Le prove iniziali hanno incluso ricodifiche e conversioni, tra cui JPEG/DCT in CMYK e RGB, che consentivano di visualizzare le immagini. Sono verifiche utili per cercare alternative, ma cambiano più variabili e non bastano a individuare quale campo determini il comportamento.
Il confronto più controllato consiste invece nel mantenere identico il codestream JPEG 2000 e cambiare soltanto due byte della ftyp. Sulla coppia definitiva, usando PDFPage.thumbnail di PDFKit su macOS 26.6.2, build 25G83, abbiamo ottenuto:
BR="jpx ", CLi="jpx " + stesso codestream → PDFKit: pagina bianca

BR="jp2 ", CLi="jp2 " + stesso codestream → PDFKit: immagine visibile
Nei due container definitivi il box rreq (Reader Requirements) è assente in entrambe le varianti. La presenza o l’assenza di questo box non costituisce quindi una differenza tra GOOD e BAD. L’assenza di rreq è però rilevante quando si valuta la conformità JPX.
Il confronto byte per byte e le prove controllate permettono di associare il cambio di risultato alla ftyp in questi input. Non consentono, da soli, di ricostruire il percorso interno del decoder Apple.
Due PDF con due soli byte di differenza
La coppia definitiva è stata ridotta alle strutture necessarie per il test, rimuovendo i manifest C2PA e il commento del codestream. Il confronto riguarda i due PDF così ottenuti, ciascuno lungo 192.196 byte.
Entrambi:
hanno una sola pagina;
contengono una sola immagine;
misurano 192.196 byte ciascuno;
utilizzano /JPXDecode;
utilizzano DeviceCMYK;
contengono lo stesso codestream nel box jp2c;
hanno identica struttura PDF.
Nell’intero PDF cambiano soltanto i byte agli offset 506 e 514, contando da zero (rispettivamente 0x1FA e 0x202). Sono gli offset 22 e 30 dall’inizio dello stream JPEG 2000: il primo appartiene al brand principale, il secondo all’unica voce della compatibility list. La versione minore resta zero. Lo spazio finale nei brand seguenti è parte del valore.
Nella variante GOOD, che il PDFKit verificato visualizza:
brand principale (BR):       "jp2 "
versione minore (MinV):      0
unica compatibilità (CLi):   "jp2 "
Nella variante BAD, in cui il PDFKit verificato non visualizza l’immagine:
brand principale (BR):       "jpx "
versione minore (MinV):      0
unica compatibilità (CLi):   "jpx "
Dal punto di vista binario, in ciascuna delle due posizioni cambia solamente:
0x32 "2"
in:
0x78 "x"
La verifica è stata eseguita direttamente con PDFKit, tramite PDFPage.thumbnail, su macOS 26.6.2, build 25G83. Questo test dell’API va distinto dalle osservazioni effettuate nell’app Anteprima sul documento originario:
Variante JPX_BAD → PDFKit produce una pagina bianca.
Variante JP2_GOOD → PDFKit visualizza l’immagine.
Con Poppler 25.06.0, invece, entrambi i PDF definitivi mostrano l’immagine: i rendering prodotti a 512 pixel sono identici pixel per pixel. I risultati dei diversi visualizzatori vanno sempre riferiti alle versioni e ai file effettivamente provati.
La variante JPX_BAD non mostra l’immagine nel test PDFKit descritto e la trovate a questo link: JPX_BAD.
La variante JP2_GOOD mostra invece l’immagine nello stesso test ma con la codifica corretta e la trovate a questo link: JP2_GOOD.
Con questi due file non stiamo confrontando due immagini ricodificate diversamente: il codestream JPEG 2000 è identico tra GOOD e BAD, ma i due pdf hanno hash differenti, perché due byte sono diversi. L’espressione “stesso file, stesso hash” riguarda invece l’esperimento successivo, nel quale un unico PDF viene aperto con renderer differenti.
Le impronte SHA-256 della coppia definitiva senza metadati descrittivi sono riportate qui sotto. Consentono di verificare che i file scaricati coincidano con quelli analizzati: una successiva elaborazione o l’aggiunta di metadati può modificarli e far venir meno il confronto di due soli byte.
GOOD — 192196 byte
2270aedfdbc143090f40bb6f063d216de638757b06926e5fd07a236a162f03a2

BAD — 192196 byte
b1a52bdfac9bf5a705207f1a358b237b7eca5dd63c8cbedcd3c67adc29469cfb
Il test aggiuntivo: quale dei due byte cambia il risultato?
Abbiamo provato tutte e quattro le combinazioni del brand principale e dell’unica voce della compatibility list, modificando copie in memoria e lasciando invariati gli altri byte e nel controllo effettuato con PDFKit su macOS 26.6.2 il risultato è stato il seguente:
BR       CLi      MEDIUM          Cane-Gatto
"jp2 "   "jp2 "   immagine        gatto
"jpx "   "jp2 "   immagine        gatto
"jp2 "   "jpx "   pagina bianca   cane
"jpx "   "jpx "   pagina bianca   cane
In questi input, sul PDFKit verificato, cambiare il solo byte della compatibility list è sufficiente; cambiare soltanto il brand principale non produce la differenza. La coppia distribuita differisce per due byte, ma due byte non sono il minimo necessario a ottenere il cambio di visualizzazione nell’esperimento controllato. Le combinazioni intermedie sono varianti diagnostiche, non una certificazione di conformità dei container.
Quindi JPX è un errore e causa un baco?
JPX è un formato standard, definito dalla Part 2 di JPEG 2000. Il testcase non dimostra che JPX sia inadatto ai PDF o che il renderer Apple non possa mai visualizzarlo, né che vi sia un baco nel sistema di rendering PDF: dimostra una differenza di comportamento su una specifica coppia di input.
La specifica PDF, nella sezione dedicata a JPXDecode, prevede anche lo spazio colore enumerato 12, CMYK, occorre però distinguere questo requisito dalla conformità del container: nella variante marchiata jp2 , il box colr dichiara proprio EnumCS 12, mentre la specifica JP2 prevede per gli spazi enumerati i valori 16, 17 e 18.
Nella variante marchiata jpx manca inoltre il box rreq, richiesto dalla struttura JPX descritta nella specifica T.801: il solo cambio di brand non rende quindi il container automaticamente conforme a JP2 o JPX. Possiamo quindi parlare di una differenza di rendering riprodotta e questi file, da soli, non costituiscono una prova definitiva di violazione dello standard da parte di Apple.
La causa precisa nel software richiederebbe ulteriori verifiche, l’analisi dell’implementazione o un riscontro del produttore. Un confronto tra file pienamente conformi sarebbe inoltre necessario per separare i problemi di conformità degli input dalle diverse strategie con cui i renderer li gestiscono.
Un PDF di test per “riconoscere” il renderer
Lo stesso principio enunciat osopra può essere usato per costruire un PDF dimostrativo con due messaggi sovrapposti: il testo visibile dipende da come viene gestita l’immagine superiore, non da una vera identificazione del software.
Nelle prove descritte, il documento mostra “You are using Apple rendering” quando resta visibile l’immagine sottostante e “You are NOT using Apple rendering” quando viene dipinta quella superiore. Le scritte sono etichette dimostrative: non certificano quale motore o sistema operativo sia in uso.
Il meccanismo non richiede JavaScript, lettura dello User-Agent o riconoscimento del sistema operativo: sfrutta la diversa rappresentazione dell’oggetto JPEG 2000. Qualunque renderer con lo stesso comportamento potrebbe produrre lo stesso messaggio.
È una dimostrazione interessante di un principio più generale della document analysis: lo stesso insieme di byte può produrre rappresentazioni visive differenti a seconda dell’implementazione utilizzata per interpretarlo.
Chi produce PDF destinati a una distribuzione ampia dovrebbe privilegiare strutture conformi e verificate con più renderer. Il formato va scelto in funzione dell’immagine, dello spazio colore, della qualità richiesta e delle applicazioni destinatarie.
Pur non trattandosi di un bug, se si mantiene JPEG 2000, bisogna generare un container conforme alle funzionalità e al colore effettivamente utilizzati: JP2 non si ottiene semplicemente rinominando il brand di un’immagine CMYK. Quando compatibile con le esigenze del documento, JPEG con /DCTDecode è un’alternativa da valutare e verificare.
La scelta deve distinguere codec, container e filtro PDF. Un’estensione del nome del file o il supporto dichiarato di un formato non sostituiscono la verifica del PDF finale.
In un workflow editoriale è opportuno verificare cosa accade dopo l’esportazione dal programma d’impaginazione, ad esempio provando ad aprire il pdf con diversi software e sistemi operativi: nel documento inizialmente esaminato, che ha dato il via alla presente ricerca, i metadati indicavano Adobe InDesign come Creator e un servizio successivo come Producer, campi che rappresentano indizi sulla lavorazione, non una prova sufficiente per attribuire la modifica delle immagini a uno specifico software.
Gli strumenti per l’analisi forense dei PDF e del rendering
Per una prima verifica è utile confrontare lo stesso documento con renderer indipendenti. Il fatto che Anteprima, o qualunque altro singolo visualizzatore, non mostri un’immagine non dimostra che i suoi dati siano assenti dal PDF.
Nel controllo della coppia definitiva abbiamo confrontato PDFKit e Poppler, mentre ullteriori applicazioni, come Acrobat o Foxit, possono ampliare la matrice di prova, purché si registrino versioni e risultati senza dedurli dal solo sistema operativo.
Per JPEG 2000, OpenJPEG offre strumenti per esaminare codestream e parametri di codifica. Ad esempio, la documentazione dei parametri del codestream distingue l’identificatore della trasformata 9/7 irreversibile da quello della 5/3 reversibile. Il successo di una decodifica non equivale però alla validazione completa del container.
Per il confronto binario occorre controllare sia gli stream estratti sia l’intero PDF. Anche i metadati e gli aggiornamenti incrementali possono introdurre differenze: nelle versioni precedenti della coppia, i manifest C2PA rendevano inesatta l’affermazione “due soli byte nell’intero file”.
Per l’analisi forense del pdf a basso livello, però, spesso la cosa più utile rimane esaminare direttamente:
/Image
/Filter /JPXDecode
/ColorSpace
/SMask
e quindi estrarre lo stream, distinguere i box presenti da quelli assenti e analizzarne i campi. Tra i box pertinenti rientrano:
jP
ftyp
rreq
jp2h
colr
jp2c
L’analisi informatica forense del PDF va completata con i marker del codestream, le risorse della pagina, l’ordine di disegno e gli eventuali gruppi di trasparenza. rreq, per esempio, è pertinente alla conformità JPX ma non è presente nella coppia definitiva.
Oltre il riquadro grigio: due immagini nello stesso PDF
Nel documento iniziale il sintomo era una fotografia non visualizzata, con un’area grigia al suo posto. Nel testcase a immagine singola, il risultato verificato tramite PDFKit è invece una pagina bianca. L’esperimento successivo rende la differenza ancora più evidente.
La differenza di rendering può essere sfruttata anche per ottenere un risultato molto più evidente, cioè fare in modo che lo stesso PDF mostri due immagini completamente diverse a seconda del renderer utilizzato.
Abbiamo realizzato un PDF contenente le fotografie di un cane e di un gatto. Sul campione analizzato abbiamo riprodotto questi risultati:
con PDFKit, tramite PDFPage.thumbnail, su macOS 26.6.2 compare il cane;
con Poppler 25.06.0 compare il gatto.
Il meccanismo consiste in due immagini sovrapposte con codifiche differenti. Nella struttura analizzata non ci sono JavaScript o istruzioni per selezionare il contenuto in base al viewer. I dati pertinenti all’esperimento sono:
Pagina:               700 x 700 punti
Image XObject:        2
Immagine sottostante: cane, JPEG /DCTDecode, RGB
Immagine superiore:   gatto, JPEG 2000 /JPXDecode, CMYK
Brand del gatto:      "jpx "
Ordine di disegno:    cane, poi gatto
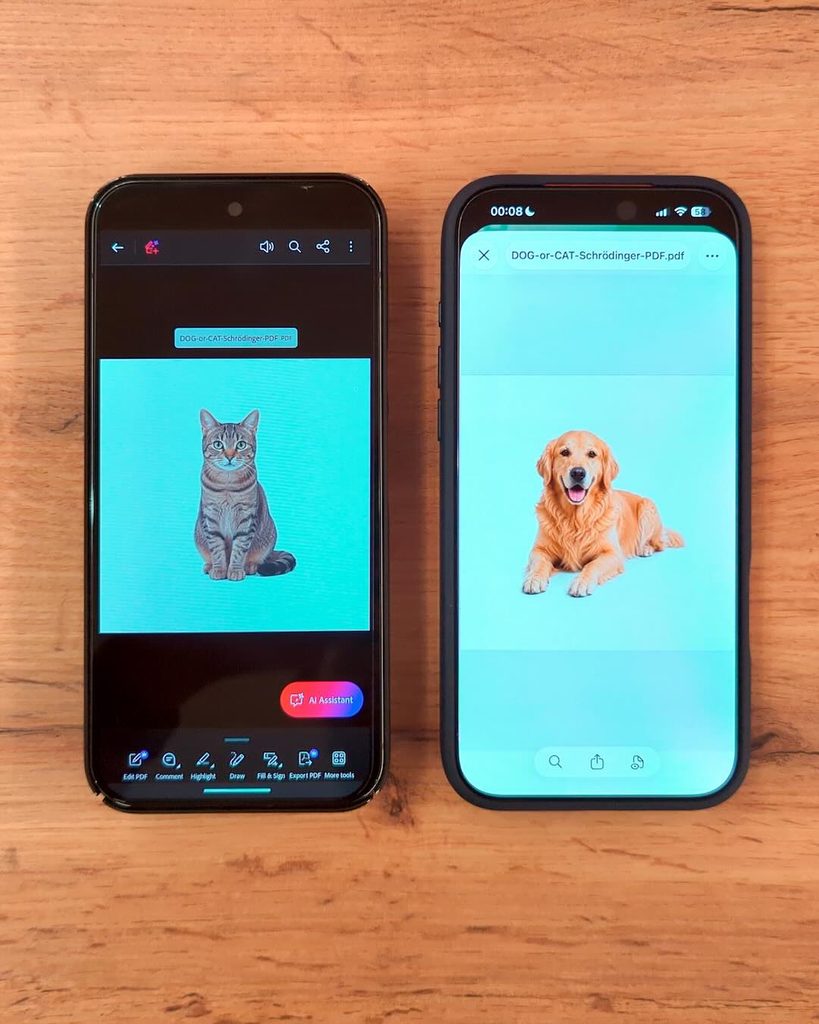
Potete scaricare il “PDF di Schrödinger”dal seguente link: il nome “PDF di Schrodinger” è una metafora, perché entrambe le immagini sono già contemporaneamente nel file e il risultato dipende dal rendering, non da una modifica del documento durante l’apertura, il pdf quindi contiene un gatto e un cane contemporaneamente.
Le immagini seguenti documentano il confronto descritto tra Anteprima e Google Chrome su macOS. Il principio dell’esperimento è aprire lo stesso file con applicazioni differenti: l’identità dei file va verificata sui byte o tramite hash, non desunta dal solo nome mostrato nelle schermate.
Il PDF di Schrödinger in Anteprima su macOS: nella prova illustrata compare il cane.
Il PDF di Schrödinger in Google Chrome su macOS: nella prova illustrata compare il gatto.
Il confronto fotografico comprende anche uno smartphone Android, a sinistra, e un iPhone, a destra: nelle applicazioni utilizzate per questa prova compaiono rispettivamente il gatto e il cane. La fotografia documenta il risultato visivo; da sola non dimostra l’identità binaria delle copie aperte né permette di generalizzare a tutte le applicazioni dei due sistemi.
PDF di Schrödinger: gatto a sinistra su Android e cane a destra su iPhone, nelle applicazioni della prova
Questi esempi vanno letti come osservazioni sugli ambienti provati. Windows, Android e iOS sono sistemi operativi, non renderer: per riprodurre il risultato occorre specificare anche l’applicazione e la sua versione.
Come funziona l’esperimento
Il principio è quello già utilizzato nel PDF dimostrativo contenente i messaggi “You are using Apple rendering” e “You are NOT using Apple rendering”, ma applicato questa volta a contenuti fotografici.
Il documento contiene entrambe le immagini: il cane è un JPEG RGB con filtro /DCTDecode, mentre il gatto è un’immagine JPEG 2000 CMYK con filtro /JPXDecode e brand jpx . Un Form XObject, inserito in un gruppo di trasparenza isolato, disegna prima il cane e poi il gatto sulla stessa area. Quando il gatto viene dipinto, copre il cane; quando non viene dipinto, resta visibile il cane sottostante.
Il comportamento osservato si può quindi descrivere così:
Il gatto superiore non viene dipinto → resta visibile il CANE.
Il gatto superiore viene dipinto → copre il cane e compare il GATTO.
Il PDF non “decide” quale applicazione lo sta aprendo. Non contiene una condizione “se Apple mostra A, altrimenti mostra B”: il risultato dipende dall’esecuzione delle istruzioni di disegno da parte del renderer. I byte della ftyp riguardano il container del gatto; non trasformano il codestream di un animale in quello dell’altro.
Il problema non è più solo un’immagine che non si vede
Nel documento che ha originato la presente analisi la differenza della codifica poteva essere interpretata semplicemente come una fotografia non visualizzata. Il testcase Cane-Gatto rende invece evidente che l’omissione di un’immagine può anche lasciare visibile un contenuto alternativo già presente sotto di essa e quindi mostrare due immagini diverse con lo stesso PDF.
Il testcase con cane e gatto dimostra quindi un concetto più generale: una differenza nell’interpretazione o nel rendering degli oggetti di un PDF con stesso valore hash può determinare rappresentazioni visive sostanzialmente differenti dello stesso documento.
Due persone possono quindi aprire copie dello stesso file, verificarne l’hash e vedere contenuti differenti utilizzando software diversi. Questo è rilevante anche quando il documento viene esaminato prima di una firma: l’identità dei dati non garantisce l’identità di ciò che viene mostrato. Il testcase non costituisce però una prova del comportamento di uno specifico workflow di firma, che richiede verifiche separate.
Non è un sistema universale per riconoscere il viewer. Il risultato potrebbe cambiare con versioni differenti delle applicazioni o delle librerie, e lo stesso comportamento potrebbe essere condiviso da renderer diversi.
L’interesse nell’ambito informatico forense
Dal punto di vista della digital forensics, il confronto degli hash crittografici è uno strumento per verificare l’identità delle copie. Non è una verifica dell’equivalenza dei rendering: questa richiede osservazioni e confronti ulteriori.
In presenza di anomalie o contestazioni è utile documentare hash del file, sistema operativo, applicazione, versione, modalità di apertura e, quando noto, motore di rendering. È altrettanto utile conservare l’originale, distinguere le copie di lavoro e confrontare il risultato con un’implementazione indipendente.
Il cane e il gatto rendono visibile un limite pratico: l’esame del solo risultato a schermo non esaurisce l’analisi del documento.
Conclusioni
Da un documento editoriale con immagini non visualizzate siamo arrivati a una coppia controllata: una pagina, una sola immagine, stessa dimensione e due soli byte differenti nella ftyp, con codestream identico. Il PDFKit verificato mostra l’immagine nella variante GOOD e una pagina bianca nella variante BAD.
Poppler 25.06.0 produce invece lo stesso rendering per entrambe. Il test sulle quattro combinazioni dei campi ha mostrato inoltre che, nell’ambiente PDFKit verificato, basta il cambiamento del solo byte della compatibility list per modificare il risultato. Questo dettaglio restringe l’osservazione sperimentale, senza identificare da solo la causa nel software.
La differenza è riproducibile, ma i limiti di conformità dei container impediscono di presentare la coppia come prova definitiva di una violazione normativa di Apple. Per chi produce o analizza PDF, il criterio operativo è usare strutture conformi, conservare gli originali e verificare il documento finale con più renderer, senza trattare il cambio di brand come una riparazione universale.
In questa coppia, tra un PDF che mostra l’immagine e uno che sembra averla persa ci sono letteralmente due byte. Nel PDF Cane-Gatto non cambia neppure un byte tra un’apertura e l’altra: cambia il software che lo interpreta.
Il 29 agosto 2026 la Questura di Frosinone ha pubblicato un avviso relativo a una nuova ondata di attacchi zero-click contro la clonazione account WhatsApp su dispositivi Apple. L’allarme descrive uno scenario in cui le vittime trovano messaggi inviati dal proprio numero WhatsApp senza aver autorizzato alcun dispositivo, con richieste di denaro urgenti rivolte ai propri contatti. La Polizia di Stato raccomanda di mantenere aggiornati sistema operativo e applicazione, controllare periodicamente i dispositivi collegati e attivare la verifica in due passaggi.
Si tratta di uno scenario che il nostro laboratorio aveva già analizzato e segnalato a Meta nei mesi precedenti.
Le prime evidenze raccolte: maggio 2026
A maggio 2026 il nostro laboratorio ha ricevuto i primi casi di account WhatsApp compromessi su iPhone con iOS 16. L’analisi forense ha rivelato un pattern coerente e preoccupante: tutti i dispositivi coinvolti erano iPhone con versioni di iOS 16 non aggiornate all’ultima patch disponibile, nessun dispositivo risultava collegato nella sezione “Dispositivi collegati” di WhatsApp e la compromissione avveniva senza alcuna azione richiesta alla vittima – uno scenario compatibile con un attacco zero-click.
La prova di laboratorio: replica della sessione
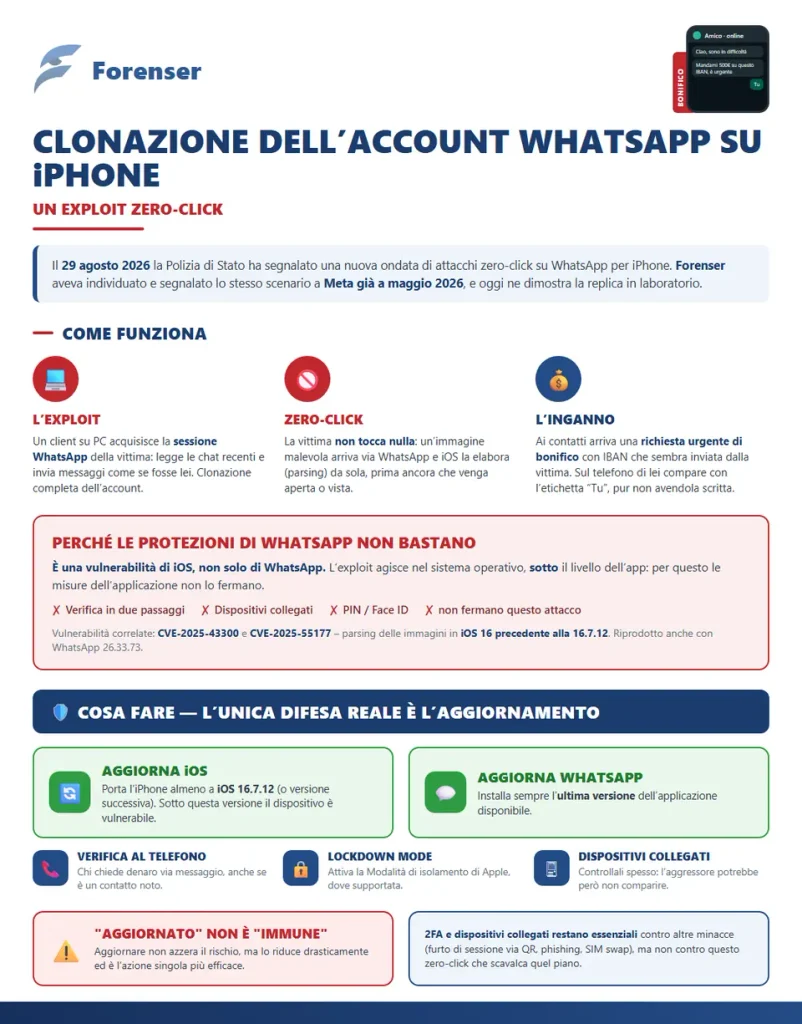
Dopo la segnalazione a Meta, che ha preso in seria considerazione la nostra comunicazione, il team ha proseguito la ricerca e replicato in laboratorio lo scenario osservato, riuscendo a riprodurre lo scenario 0-click. Su dispositivi di test, un client su PC ha acquisito la sessione della vittima, letto le chat recenti e inviato messaggi come titolare dell’account. È il passaggio sperimentale che sviluppa quanto documentato nel precedente articolo.
La dimostrazione mostra simultaneamente tre schermi: il client dell’attaccante su PC, l’iPhone della vittima e il dispositivo del destinatario. L’attaccante invia un messaggio – una richiesta di bonifico urgente con IBAN, identica alle segnalazioni della Polizia di Stato – che appare ai contatti come proveniente dalla vittima. Quest’ultima vede il messaggio comparire nella propria chat con l’indicazione “Tu” (hai inviato tu questo messaggio), senza averlo mai scritto.
Il test è stato ripetuto con WhatsApp 26.33.73, ossia l’ultima versione disponibile al momento della scrittura, nelle condizioni controllate del laboratorio. Le prove confermano il comportamento anche sulla versione più recente di WhatsApp. E’ importante ribadire che l’attacco è compatibile con la combinazione dei CVE-2025-43300 e 2025-55177 e che il primo costituirebbe il vettore d’ingresso ed è dipendente da una versione obsoleta di iOS. Ciò significa che aggiornando il sistema operativo vi è una mitigazione, tuttavia WhatsApp resterebbe vulnerabile e quindi è possibile che successive vulnerabilità di iOS potrebbero essere sfruttate per perpetrare l’attacco anche sulle versioni più recenti del sistema operativo.
Tradotto in termini meno tecnici, ciò significa che vulnerabilità non note (0-day) che affliggono il sistema operativo di Apple potrebbero essere impiegate per sfruttare il baco di WhatsApp. In sostanza aggiornare non mitiga completamente il rischio ma riduce drasticamente la probabilità di essere infettati.
Schema riassuntivo dell’exploit di clonazione dell’account WhatsApp su iPhone e delle mitigazioni
Le vulnerabilità nello specifico
Gli advisory pubblici descrivono una catena composta da due problemi distinti: un difetto di autorizzazione in WhatsApp, utilizzabile per innescare l’elaborazione di contenuti remoti, e una vulnerabilità del framework ImageIO a “livello Apple”. Le protezioni dell’account come la verifica in due passaggi, controllo dei dispositivi collegati, PIN e blocco biometrico dell’app, restano utili contro altri vettori, ma non sostituiscono le patch che correggono questi difetti del codice.
Meta indica che CVE-2025-55177, presente in WhatsApp per iOS prima della 2.25.21.73, poteva consentire a un soggetto non correlato di innescare sul dispositivo bersaglio l’elaborazione di contenuti da un URL arbitrario. Apple descrive CVE-2025-43300 come una scrittura fuori dai limiti del buffer delle librerie vulnerabili in ImageIO, con possibile corruzione della memoria durante l’elaborazione di un’immagine malevola, corretta sul ramo iOS 16 a partire dalla 16.7.12. Meta valuta che le due vulnerabilità possano essere state usate insieme in attacchi sofisticati e mirati.
Uno zero-click non richiede che la vittima apra un messaggio, tocchi un link o autorizzi un’operazione. Negli advisory, il difetto WhatsApp poteva innescare l’elaborazione di contenuti remoti e la falla ImageIO essere attivata da un’immagine malevola. Il punto di ingresso è l’elaborazione automatica, non un gesto dell’utente: a differenza delle forme più comuni di phishing, non esiste un link che la vittima possa scegliere di non aprire.
Installare le versioni corrette chiude le vulnerabilità note descritte qui. Questo non rende però un dispositivo immune da ogni attacco futuro: una catena diversa può sfruttare una vulnerabilità nuova, precedentemente sconosciuta e non ancora corretta.
Per comprendere il motivo per cui “aggiornato” non significa “invulnerabile”, occorre distinguere quattro condizioni:
Vulnerabilità zero-day: un attaccante può sfruttare una falla nuova prima che il produttore abbia potuto correggerla. Gli aggiornamenti disponibili non possono contenere una patch che ancora non esiste;
Finestra di esposizione: anche dopo la scoperta di una falla passa del tempo prima che la correzione venga sviluppata, distribuita e installata. In quella finestra il rischio resta, soprattutto per bersagli selezionati. Questa è la condizione odierna;
Compromissione già avvenuta: una patch chiude il vettore noto, ma non certifica da sola la bonifica del telefono né la revoca di una sessione già sottratta. La persistenza varia e va verificata caso per caso con analisi forense; senza evidenze specifiche non è possibile affermare che questa compromissione non sopravviva all’aggiornamento;
Supporto del dispositivo: i modelli che restano sul ramo iOS 16 devono installare l’ultima patch disponibile – al momento della pubblicazione, iOS 16.7.16 – e valutare la sostituzione del dispositivo.
In breve: “aggiornato” non significa “immune”, ma nemmeno “ancora vulnerabile alla stessa falla”. Aggiornare iOS e WhatsApp resta la prima azione da compiere; se l’account è già compromesso, occorre anche avviare il recupero, rinnovare l’autenticazione e valutare l’assistenza forense prima di operazioni che possano cancellare prove.
Consigli finali
Si vuole di seguito riassumere un elenco di buone pratiche indipendenti dall’attacco:
Verificare l’identità di chi chiede denaro utilizzando un canale separato: una telefonata al numero già noto, un altro dispositivo o, quando possibile, un contatto di persona.
Per i soggetti più esposti, valutare due protezioni diverse: la Modalità di isolamento di Apple e le Impostazioni restrittive dell’account di WhatsApp. Entrambe riducono la superficie d’attacco, con possibili limitazioni d’uso. L’impiego della modalità d’isolamento non sostituisce un aggiornamento disponibile.
Controllare periodicamente la sezione “Dispositivi collegati” di WhatsApp e disconnettere ciò che non si riconosce, sapendo che nello scenario descritto il client dell’aggressore potrebbe non comparire nell’elenco.
Se l’account risulta già compromesso, avvisare subito i contatti, avviare la procedura di recupero e, quando è necessario preservare le prove, rivolgersi a un professionista prima di reinstallare o inizializzare il dispositivo.
Conclusioni
Il nostro laboratorio continua a monitorare l’evoluzione di questa famiglia di attacchi e mantiene aperto il canale di comunicazione con Meta per la segnalazione di eventuali sviluppi. Nel frattempo il nostro Studio ha condiviso a Meta l’ambiente che replica l’attacco con l’indicazione precisa della vulnerabilità sfruttata dagli attaccanti.
La raccolta tempestiva di bug report, Debug Logs e log anti-intrusione permette di conservare informazioni utili per ricostruire anomalie e possibili eventi di sicurezza su Android
Durante un’analisi, un incidente o una semplice attività di assistenza tecnica può essere necessario raccogliere informazioni diagnostiche da uno smartphone Android.
A differenza di iPhone e iPad, Android non dispone di un singolo archivio perfettamente equivalente al sysdiagnose, il pacchetto diagnostico unico dei dispositivi Apple. Le fonti principali sono tre:
il bug report, che raccoglie in un archivio lo stato diagnostico del dispositivo;
i Debug Logs, ottenuti tramite logcat, utili per osservare ciò che accade durante un problema;
il Log anti-intrusioni, introdotto con Android 16 per conservare nel tempo eventi rilevanti per la sicurezza.
Sono strumenti complementari e non intercambiabili.
Generare un bug report dal dispositivo
Il bug report è un archivio .zip che raccoglie log di sistema, crash, informazioni sui processi e altri dati tecnici prodotti dai componenti interni del sistema. Le dimensioni possono variare da alcune decine a diverse centinaia di MB, in base al dispositivo e ai dati disponibili.
Può essere utile per analizzare crash, blocchi, errori ANR (le app che si bloccano senza rispondere), consumi energetici anomali, problemi di rete e altri comportamenti inattesi.
Per generarlo direttamente dal dispositivo è necessario attivare le Opzioni sviluppatore, un menu nascosto di funzioni avanzate.
Nella maggior parte dei dispositivi:
aprite Impostazioni > Informazioni sul telefono;
individuate la voce Numero build;
toccatela sette volte;
inserite il PIN, se richiesto.
Successivamente:
aprite Impostazioni > Sistema > Opzioni sviluppatore;
selezionate Crea report bug, Segnalazione bug o una voce equivalente;
se vengono proposte due varianti, il Report interattivo è adatto alla maggior parte dei casi e permette di aggiungere dettagli e screenshot; il Report completo include tutte le sezioni diagnostiche, ma non permette queste integrazioni: sceglietelo quando chi riceverà il file lo richiede espressamente;
avviate la raccolta.
La raccolta richiede qualche minuto: al termine comparirà una notifica attraverso la quale sarà possibile salvare o condividere l’archivio.
Su Pixel e su alcuni altri dispositivi, sempre nelle Opzioni sviluppatore, è disponibile anche la Scorciatoia segnalazione bug: aggiunge la voce al menu di accensione e consente di avviare la raccolta nel momento esatto in cui il problema si manifesta, senza dover navigare nei menu. Sui Pixel recenti il menu si apre premendo insieme Accensione e Volume Su, come indicato nella guida Pixel.
Il nome del file sarà generalmente simile a:
bugreport-BUILD_ID-DATE.zip
dove al posto di BUILD_IDeDATE troverete la versione del software e la data di creazione.
Il percorso e il nome delle opzioni possono variare in base al produttore. La procedura generale è documentata da Android Developers.
Generare il bug report da computer con ADB
Il bug report può essere generato anche da computer, su macOS, Linux o Windows, tramite ADB (Android Debug Bridge): è lo strumento a riga di comando con cui il computer dialoga con un dispositivo Android, ed è incluso negli SDK Platform Tools ufficiali di Google. Non serve installare nulla: scaricate l’archivio, estraetelo e aprite il Terminale nella cartella appena estratta. Su Windows il modo più rapido è digitare cmd nella barra degli indirizzi di quella cartella e premere Invio; su Mac si fa clic destro sulla cartella e si sceglie “Nuovo terminale nella cartella”.
Negli esempi successivi viene utilizzato adb. Su macOS e Linux, se state eseguendo il programma direttamente dalla cartella estratta, sostituitelo con ./adb, per esempio ./adb devices.
Sul dispositivo:
abilitate Debug USB nelle Opzioni sviluppatore: è l’interruttore che consente al computer di comunicare con lo smartphone;
collegate lo smartphone al computer via USB;
sbloccatelo;
confermate la richiesta di autorizzazione che compare sullo schermo: l’impronta RSA mostrata identifica il computer che state autorizzando, quindi accettatela solo se siete voi ad aver appena collegato il dispositivo al vostro computer.
Dal computer verificate che il dispositivo sia visibile:
adb devices
Se tutto è a posto comparirà il numero di serie dello smartphone seguito dalla parola device. Se invece compare unauthorized, sbloccate lo smartphone e confermate l’autorizzazione.
A questo punto avviate la generazione:
adb bugreport
Non serve altro: ADB chiede al dispositivo di generare il bug report, attende che sia pronto e salva l’archivio .zip nella cartella in cui vi trovate. L’operazione può richiedere alcuni minuti.
Se sono collegati più dispositivi, indicate quale usare con il numero di serie mostrato da adb devices:
adb -s NUMERO_SERIALE bugreport
Conservate il file .zip originale senza estrarlo, modificarlo o ricomprimerlo.
Raccogliere i Debug Logs con logcat
I Debug Logs sono i messaggi prodotti in tempo reale dal sistema operativo e dalle applicazioni. Android li conserva in aree di memoria di dimensione limitata, i buffer: quando si riempiono, i dati più vecchi vengono sovrascritti dai nuovi.
Per questo motivo devono essere raccolti il prima possibile.
Si presentano due situazioni tipiche.
Il problema è riproducibile: avviate la registrazione con:
adb logcat -b all -v threadtime > debug-logs.txt
Lasciate il comando in esecuzione, riproducete il problema e interrompete la raccolta premendo Ctrl+C.
Il problema è appena avvenuto e non potete (o non volete) riprodurlo: salvate ciò che il dispositivo ha ancora in memoria; in questo caso il comando termina da solo:
adb logcat -b all -v threadtime -d > debug-logs.txt
In entrambi i casi il file debug-logs.txt viene creato nella cartella in cui vi trovate. I due comandi sono identici a parte l’ultima opzione: chiedono di leggere tutti i buffer disponibili (-b all) con data, ora, priorità, PID e TID (-v threadtime), e la -d del secondo dice a logcat di salvare quanto già presente e fermarsi, invece di restare in ascolto.
Su Windows eseguite questi comandi dal Prompt dei comandi (cmd.exe): Windows PowerShell 5.1 salva il file in una codifica (UTF-16LE) che alcuni strumenti di analisi non leggono correttamente, mentre PowerShell 7 usa UTF-8 e non ha questo problema.
I Debug Logs servono a osservare un errore mentre avviene; il bug report fotografa invece lo stato complessivo del dispositivo. La sintassi completa di logcat è descritta nella documentazione ufficiale Android.
Il nuovo Log anti-intrusioni di Android 16
Con Android 16 Google ha introdotto Intrusion Logging, chiamato nell’interfaccia italiana Log anti-intrusioni.
La funzione fa parte della modalità Protezione avanzata ed è stata sviluppata anche con il contributo dell’Amnesty International Security Lab.
A differenza del bug report e dei Debug Logs, conserva nel tempo eventi selezionati appositamente per le analisi di sicurezza, tra cui:
avvio dei processi delle applicazioni;
installazioni, aggiornamenti e disinstallazioni;
interrogazioni DNS (la traduzione dei nomi dei siti in indirizzi) e connessioni verso indirizzi IP;
attività e comandi ADB;
trasferimenti di file tramite USB;
modifiche ai certificati;
blocchi e sblocchi del dispositivo.
I log vengono crittografati sul dispositivo e archiviati nell’Account Google scelto dall’utente. Google dichiara di non poterli leggere. Vengono conservati per 12 mesi e non possono essere eliminati manualmente prima della scadenza.
La funzione deve essere attivata prima dell’evento da analizzare: non permette di recuperare retroattivamente informazioni relative al periodo in cui era disabilitata.
Attivare ed esportare il Log anti-intrusioni
L’attivazione viene proposta durante la configurazione della modalità Protezione avanzata; è comunque possibile intervenire in un secondo momento:
aprite Impostazioni > Sicurezza e privacy;
selezionate Protezione avanzata;
attivate Protezione del dispositivo;
abilitate Log anti-intrusioni durante la configurazione oppure aprite successivamente la relativa voce;
scegliete l’Account Google nel quale conservare i log crittografati;
riavviate il dispositivo, se richiesto.
I nomi e l’ordine delle voci possono variare in base al produttore e alla versione di Android.
I file saranno disponibili nel gestore file, normalmente nella cartella:
Download/Intrusion Logging/
La disponibilità della funzione dipende dal dispositivo e dagli aggiornamenti installati. Le procedure ufficiali e le implicazioni per la privacy sono riportate nella guida di Google e nell’approfondimento di Amnesty International.
Alcuni limiti da conoscere
La recente analisi pubblicata da iVerify conferma il valore del Log anti-intrusioni, ma evidenzia anche alcuni limiti:
non registra ogni attività del dispositivo;
il caricamento non è in tempo reale: le ultime 12-24 ore potrebbero mancare;
la cronologia delle reti Wi-Fi non viene registrata;
le installazioni non indicano la provenienza dell’app (Play Store, installazione manuale da file APK o ADB);
delle sessioni ADB interattive registra l’apertura, non i comandi digitati;
gli spegnimenti non lasciano traccia: l’orario va dedotto dai vuoti di attività.
Come condividere i file
Tutte e tre le raccolte possono contenere dati personali: app installate, identificatori del dispositivo, attività di sistema e connessioni di rete. Condividetele solo con il destinatario previsto, tramite un canale cifrato oppure un link o un archivio protetti da password, comunicata separatamente.
Accompagnate i file con data e ora esatta dell’anomalia (con fuso orario), modello del dispositivo, versione di Android, una breve descrizione dell’accaduto e l’orario della raccolta.
Come accortezza generale, bug report e Debug Logs vanno raccolti il prima possibile dopo il problema; il Log anti-intrusioni, invece, va abilitato preventivamente.
Il pacchetto sysdiagnose raccoglie i log diagnostici di iPhone e iPad per attività di assistenza tecnica, incident response e analisi forense
Durante un’analisi, la gestione di un incidente o una semplice attività di assistenza tecnica, capita sempre più spesso di chiedere a qualcuno di generare un “sysdiagnose” del proprio iPhone o iPad. E la risposta è quasi sempre la stessa: “Un che cosa?”.
Il sysdiagnose è un archivio diagnostico prodotto su richiesta da iOS e iPadOS. Il file, in formato .tar.gz, contiene una fotografia molto dettagliata dello stato del dispositivo, incluse informazioni provenienti da diverse parti del sistema operativo, log di sistema e crash report recenti.
Può essere utile per analizzare blocchi, crash, consumi energetici anomali, problemi di rete e altri comportamenti inattesi.
I due modi per generarlo dall’iPhone o dall’iPad
Metodo A – la combinazione di tasti
È il metodo standard documentato da Apple:
Premete contemporaneamente Volume Su, Volume Giù e il tasto laterale o superiore, quindi rilasciateli immediatamente.
Il sysdiagnose viene avviato al rilascio dei pulsanti: non teneteli premuti in attesa di una conferma.
Su iPhone, una breve vibrazione conferma generalmente l’avvio della raccolta; su iPad la vibrazione non è prevista.
Gli errori più comuni sono tre:
prolungare la pressione: il dispositivo potrebbe bloccarsi oppure mostrare la schermata di spegnimento o di SOS emergenze. La pressione deve essere breve e simultanea.
premere i tasti in sequenza: tutti e tre devono essere premuti contemporaneamente.
cercare immediatamente il file: la raccolta richiede diversi minuti e Apple indica che può impiegarne fino a dieci.
Metodo B – AssistiveTouch
È il metodo meno noto, ma spesso più comodo se i tasti fisici sono danneggiati oppure se si vogliono evitare catture di schermata o altri errori generici sopra riportati:
Impostazioni > Accessibilità > Tocco > AssistiveTouch, e si attiva AssistiveTouch;
si tocca “Personalizza menu principale” e si aggiunge la voce Analisi;
compare il pulsante flottante: si riproduce il problema, si tocca il pulsante e si sceglie Analisi.
Comparirà un’indicazione che segnala la raccolta dei dati analitici in corso.
Dove trovare il file
Dopo qualche minuto, il sysdiagnose sarà disponibile in:
Impostazioni > Privacy e sicurezza > Analisi e miglioramenti > Dati di analisi
L’elenco può essere molto lungo. Utilizzate la funzione di ricerca, oppure scorrete fino a individuare il file più recente il cui nome inizia con:
Se il file non compare immediatamente, attendete fino a dieci minuti e controllate nuovamente. Se continua a non essere presente, è possibile che la combinazione di tasti non sia stata rilevata e che la raccolta non sia mai iniziata.
Il file può occupare centinaia di megabyte: è normale e non indica un errore.
Recuperare il sysdiagnose da Mac con libimobiledevice
Il Mac non genera il sysdiagnose dell’iPhone o dell’iPad, ma può recuperarne una copia dopo che l’archivio è stato creato sul dispositivo.
Prima di proseguire, generate quindi il sysdiagnose con uno dei due metodi descritti sopra e attendete il completamento della raccolta.
Per trasferirlo è possibile utilizzare libimobiledevice, una suite open source che consente di comunicare con i dispositivi Apple.
Se utilizzate Homebrew e la suite non è ancora installata, da Terminale eseguite:
brew install libimobiledevice
Collegate l’iPhone o l’iPad al Mac tramite USB e sbloccate il dispositivo. Se compare la richiesta “Vuoi autorizzare questo computer?”, selezionate Autorizza.
Da Terminale eseguite:
idevicepair pair
Il comando effettua il pairing e consente al dispositivo di comunicare con il Mac.
Dalla directory nella quale volete conservare i file, create una cartella dedicata al dispositivo – nel caso in esempio un iPhone 11 – e una seconda cartella chiamata sysdiagnose:
mkdir -p "iPhone 11/sysdiagnose"
Posizionatevi quindi al suo interno:
cd "iPhone 11/sysdiagnose"
Le virgolette sono necessarie perché il nome iPhone 11 contiene uno spazio.
In seguito recuperate i file diagnostici, eseguendo esattamente questo comando:
idevicecrashreport -e -k .
Il punto finale indica la cartella corrente come destinazione. L’opzione -e estrae i crash report disponibili, mentre -k mantiene una copia dei report anche sul dispositivo.
Attendete che il caricamento di tutti i file sia terminato.
Al termine, tornate alla cartella precedente con il comando:
cd ..
Quindi create l’archivio compresso:
tar -czvf sysdiagnose.tar.gz sysdiagnose
Le opzioni utilizzate significano:
c: crea un nuovo archivio;
z: applica la compressione gzip;
v: mostra a schermo i file elaborati;
f: indica il nome del file da creare, in questo caso sysdiagnose.tar.gz.
Al termine troverete il file sysdiagnose.tar.gz all’interno della cartella iPhone 11. L’archivio conterrà l’intera cartella esportata e potrà quindi includere, oltre al sysdiagnose, anche altri report diagnostici recuperati dal dispositivo: è questo bundle completo che potrete inviare al destinatario.
Come condividerlo
Dal dispositivo aprite il file individuato in Dati di analisi, toccate l’icona di condivisione in alto a destra e scegliete una delle opzioni disponibili:
AirDrop, generalmente la soluzione più rapida.
Salva su File, per conservarlo localmente o caricarlo successivamente su un servizio di trasferimento.
Un portale di assistenza o un collegamento protetto concordato con il destinatario.
Attenzione alla riservatezza
Il sysdiagnose può contenere informazioni personali e dati sensibili relativi al dispositivo, alle applicazioni e alle attività di sistema.
Condividetelo esclusivamente con il destinatario previsto e attraverso un canale sicuro. Se utilizzate un collegamento cloud, è consigliabile impostare una scadenza e una password, comunicando quest’ultima attraverso un canale separato.
Come accortezza generale, è consigliabile generare il sysdiagnose il prima possibile dopo l’anomalia e accompagnarlo con l’orario esatto e una breve descrizione dell’accaduto. Queste informazioni possono aiutare a interpretare i dati raccolti.
In un precedente articolo pubblicato pochi giorni fa avevamo raccontato il primo stadio della catena: la ricostruzione dell’exploit BootROMusbliter su un iPhone XS di test, con il dispositivo che transitava in modalità PWND DFU, lo stato di accesso più profondo ottenibile prima che qualsiasi componente del sistema operativo Apple venga caricato. Era la prima porta della catena. Oggi documentiamo il completamento dello stadio successivo: il boot di un ramdisk SSH sull’iPhone XS con iOS 18.7.9 installato, l’accesso al filesystem del dispositivo via sessione root, e la conferma che la catena costruita è riproducibile end-to-end.
Il risultato non è un jailbreak – il dispositivo torna alla condizione di partenza al primo reboot, senza modifiche persistenti alla memoria flash – ma è la conferma che la metodologia documentata dalla ricerca pubblica sui SoC A12 è oggi praticabile anche su iOS 18.7.9, la release stabile più recente disponibile al momento della verifica.
Sessione SSH sull’iPhone XS con ramdisk attivo. Il banner mostrato è quello del nostro ambiente di ricerca; la shell root è sul dispositivo, l’accesso avviene via port forwarding USB. ECID e nomi identificativi sono stati oscurati per motivi di privacy
Dove eravamo: lo stadio uno
Nell’articolo precedente avevamo descritto la fase iniziale della catena: il caricamento sull’iPhone XS di un handler personalizzato all’interno della BootROM, tramite il payload dell’exploit usbliter distribuito attraverso un Raspberry Pi Pico configurato come ponte USB. Il risultato di quella fase era la modalità PWND DFU: il device visibile al sistema operativo host come dispositivo Apple in DFU, ma con un handler custom installato nella BootROM che esponeva due opcode aggiuntivi (CUSTOM_DEMOTE e CUSTOM_BOOT). Il dispositivo restava però in una condizione di attesa: il payload era iniettato, ma nulla girava ancora in esecuzione vera e propria oltre alla BootROM stessa.
Lo stadio uno è la porta d’ingresso, ma non è utile in sé. Serve un secondo stadio che faccia partire un ambiente controllato dall’operatore – un iBoot patchato che accetti immagini non firmate, un kernel patchato per disattivare i controlli di integrità, un ramdisk custom che contenga gli strumenti di acquisizione e analisi. È questo che abbiamo costruito nei giorni successivi.
L’ecosistema di riferimento: il progetto ICH
La ricerca pubblica su A12/A13 si è consolidata negli ultimi mesi attorno a un ecosistema di repository su GitHub che coprono i diversi livelli della catena: il firmware per il microcontrollore che esegue l’exploit iniziale, il toolkit di post-exploitation con le primitive di lettura/scrittura sulla BootROM, i patchfinder che identificano gli offset corretti nel kernel e nell’iBoot per la versione di iOS in uso, gli script di orchestrazione che assemblano l’insieme in una procedura eseguibile.
Per la costruzione del bootchain patchato – in particolare per la patch dell’iBoot che consente il caricamento delle immagini firmware non firmate da Apple, per la patch del kernel che disabilita AMFI (Apple Mobile File Integrity) e i controlli di debug, e per l’assemblaggio del ramdisk custom che permette l’esecuzione del kernel patchato – ci siamo basati sul progetto open source ICH_A12_plus_Ramdisk, sviluppato dal ricercatore Pa7r0n e disponibile pubblicamente su GitHub all’indirizzo github.com/Pa7r0n/ICH_A12_plus_Ramdisk. Il progetto automatizza l’intera fase di build del bootchain per SoC A12 e A13 e per iOS dalla versione 17 alla 27, integra i patchfinder di riferimento, gestisce l’estrazione parziale dei firmware dall’IPSW ufficiale Apple e produce un bootchain firmato con il certificato IM4M generico per l’A12.
Il progetto richiede un ambiente macOS Apple per la fase di build, perché alcuni strumenti di manipolazione dei formati di firmware Apple (IMG4, IM4M, wrapping dei coprocessori) esistono solo come binari Mach-O nativi. La fase di flash del microcontrollore e la sessione di boot successiva possono avvenire da qualsiasi macchina con libimobiledevice funzionante.
L’iPhone XS di test durante la fase di boot del ramdisk. Sullo schermo compare lo sfondo nero (bgcolor) e il logo pre-registrato del progetto: sono i segnali visibili dell’iBoot Recovery che risponde ai comandi. Poco dopo il kernel patched viene lanciato e dropbear inizia ad accettare connessioni SSH
La catena tecnica in sintesi
La sequenza documentata e verificata sul nostro iPhone XS è composta da tre fasi principali. Ogni fase richiede il completamento della precedente e non è persistente al reboot del device: questa è una caratteristica desiderabile per un’attività di ricerca forense, perché garantisce che l’intervento sull’oggetto in analisi sia limitato alla sessione corrente.
Fase 1 – Applicazione dell’exploit BootROM (PWND DFU)
Il dispositivo, portato manualmente in modalità DFU, viene connesso a un Raspberry Pi Pico 2 (microcontrollore RP2350) preventivamente programmato con il firmware usbliter. Il Pi Pico innesca la vulnerabilità nel controller USB della BootROM A12 e inietta lo shellcode custom. In circa 700 millisecondi il dispositivo è in stato PWND DFU: il descrittore USB espone la stringa aggiuntiva PWND:[usbliter8] che conferma il buon esito dell’iniezione. Il dispositivo viene ora scollegato dal Pi Pico e riconnesso direttamente al computer di lavoro tramite un cavo Lightning con connettore USB-A.
Fase 2 – Boot di un iBoot patchato in modalità Recovery
Dal computer di lavoro il tool usbliter8ctl (script Python distribuito con l’ecosistema di riferimento) invia al dispositivo un iBoot personalizzato – costruito nella fase di build dal progetto ICH – tramite l’opcode CUSTOM_BOOT esposto dall’handler installato nella BootROM. L’iBoot personalizzato contiene una patch chirurgica al validatore image4 (due istruzioni ARM64 sostituite in un punto identificato dinamicamente dal patchfinder) che permette il caricamento di immagini firmware successive non firmate da Apple. Il device passa dalla modalità DFU alla modalità Recovery, riconoscibile perché libimobiledevice ora vede il dispositivo con la stringa MODE: Recovery invece di MODE: DFU.
Fase 3 – Caricamento della catena di boot completa e avvio del kernel
All’iBoot in modalità Recovery vengono ora inviati, nell’ordine documentato dal progetto ICH: il DeviceTree, il trustcache, il ramdisk contenente dropbear e gli strumenti di analisi, il kernel patchato (con le due patch AMFI e debugger applicate dal patchfinder Leeksov), e i firmware dei coprocessori (AOP, ANE, AVE, ISP, GFX, SIO) necessari alla corretta inizializzazione del bus USB nel kernel. Al termine il comando bootx innesca l’esecuzione del kernel patchato, che monta il ramdisk come rootfs, lancia il minimo indispensabile di userspace e avvia dropbear in ascolto sulla porta 22.
Log di esecuzione della catena di boot completa sul terminale del computer di lavoro. Si vedono, in ordine, l’invio dell’iBoot al dispositivo tramite CUSTOM_BOOT, la comparsa della modalità Recovery, il caricamento sequenziale dei firmware dei coprocessori, il DeviceTree, il trustcache, il ramdisk, il kernel e l’invocazione
Il momento della verità: la sessione SSH
Terminata la fase di boot, il dispositivo continua a essere visibile al computer di lavoro come dispositivo USB, ma questa volta il suo endpoint di rete è servito dal kernel appena caricato – non più dalla BootROM o dall’iBoot. Un port forwarding USB tramite iproxy (strumento standard di libimobiledevice) espone la porta 22 del dispositivo su una porta locale del computer, e da lì una comune sessione ssh apre la shell root sul telefono. La password è quella standard del ramdisk di ricerca – alpine – che rispetta la convenzione storica dei jailbreak Apple da oltre quindici anni.
Il primo comando eseguito sulla shell è mount_ich, uno strumento distribuito con il ramdisk che monta in un colpo solo tutti i filesystem del dispositivo: il volume di sistema (sealed system snapshot, sola lettura per design a partire da iOS 15), il volume Dati utente (contrassegnato APFS con flag protect, ovvero con Data Protection attiva at rest), il volume Preboot, il volume xART. A questo punto abbiamo una vista completa della struttura del filesystem del dispositivo, e – a livello di sistema operativo – l’accesso più profondo ottenibile senza modificare permanentemente il dispositivo.
Cosa vediamo e cosa non vediamo
Il fatto che i filesystem siano montati non implica che tutti i loro contenuti siano leggibili in chiaro. iOS applica la sua protezione dati a livello di singolo file, distinguendo quattro classi di protezione: dalla classe A (“Complete”, decifrabile solo quando il dispositivo è sbloccato dall’utente) alla classe D (“NoProtection”, decifrabile senza input utente perché la chiave è derivata solo dall’UID hardware). Nella condizione di ramdisk boot post-DFU il Secure Enclave non è stato coinvolto nel processo di autenticazione utente e non ha derivato le chiavi di classe A, B e C: i file appartenenti a queste classi restano cifrati a livello di storage, e la loro apertura dal ramdisk restituisce Operation not permitted.
Ciò che possiamo ottenere adesso: acquisizione BFU
Nello stato attuale della catena la nostra postazione è in grado di eseguire un’acquisizione di tipo BFU (Before First Unlock) del dispositivo: i file di classe D – che comprendono la struttura del sistema operativo, i log di sistema, i database diagnostici, un numero non trascurabile di database applicativi non protetti da Data Protection e le cache condivise – sono immediatamente leggibili e possono essere copiati bit-a-bit dal dispositivo attraverso la sessione SSH. È lo stesso livello di accesso che gli strumenti commerciali di acquisizione full file system offrono in modalità BFU e rappresenta il risultato utile per una parte rilevante dei casi di analisi che entrano nel nostro laboratorio – in particolare quando la richiesta operativa riguarda dati di sistema, log applicativi, artefatti di rete o ricostruzione di sequenze temporali.
Ciò che non escludiamo: dialogo con il Secure Enclave (AFU-equivalent)
L’accesso ai file di classe A, B e C – che comprendono la maggior parte dei database delle app di terze parti, gli attachment delle chat, il keychain e altri artefatti tipicamente rilevanti in ambito investigativo – richiede la comunicazione con il Secure Enclave dal kernel patchato attraverso l’interfaccia IOKit AppleSEPKeyStore. Quando la password del dispositivo è nota all’operatore (perché comunicata dal titolare, come avviene di frequente nelle attività di consulenza tecnica di parte, o autorizzata dal collegio giudicante), il processo consiste nel fornirla al Secure Enclave via chiamata IOKit, ricevere in risposta le chiavi di classe derivate e passare queste ultime al driver APFS del kernel per la decifratura on-the-fly dei file. Non è una capacità che possediamo oggi sul nostro laboratorio, ma non è nemmeno un obiettivo di ricerca esplorativa: è un lavoro di ingegneria mirata sopra una base già consolidata, con un margine di tuning ragionevole per portarlo a compimento.
A conferma della praticabilità dell’approccio, il progetto pubblico usbliter8-fun (github.com/34306/usbliter8-fun) documenta una catena end-to-end funzionante su iPhone 11 Pro con iOS 27 beta che va ben oltre il ramdisk SSH: include patch al kernel per bypassare le protezioni AMFI e i controlli di trust, il dialogo con il Secure Enclave per il boot del sistema operativo completo, e il ripristino di una condizione di device operativo con SpringBoard funzionante e SSH persistente. Il progetto non è direttamente riutilizzabile sul nostro iPhone XS – l’A13 e l’A12 hanno offset kernel diversi, iOS 27 introduce strutture di sicurezza (SPTM, TXM) assenti in iOS 18, e alcune scelte progettuali di quel progetto sono incompatibili con l’uso forense che ci interessa – ma dimostra che la metodologia è consolidata e che l’estensione al nostro contesto è una questione di porting mirato e non di ricerca da zero.
Prossimi passi
Il traguardo del ramdisk SSH funzionante rappresenta un punto di consolidamento significativo della catena, ma non è il traguardo finale della ricerca. Restano da affrontare almeno tre aspetti di rilievo per l’applicabilità operativa in ambito forense:
L’implementazione del dialogo con il Secure Enclave per lo sblocco delle chiavi di classe A, B e C, condizione necessaria per accedere ai file protetti da Data Protection quando la password del dispositivo è nota all’operatore o comunicata al collegio giudicante.
L’automazione della procedura di acquisizione bit-a-bit dei volumi APFS del dispositivo, con generazione degli hash di integrità della catena di custodia e produzione di un’immagine in formato standard per l’analisi successiva con strumenti di parsing forense.
L’estensione della metodologia al SoC A13 (iPhone 11, 11 Pro, iPhone SE 2020) e alle versioni più recenti di iOS su A12/A13, sulla base della ricerca pubblica in corso da parte della comunità internazionale.
Continueremo a documentare l’attività man mano che i risultati saranno consolidati. Le condizioni per una loro applicabilità in un contesto operativo – con tutte le garanzie di documentazione, riproducibilità e attendibilità che la prova digitale richiede – sono ora considerevolmente più vicine di quanto lo fossero pochi mesi fa.
Nel mondo dell’informatica forense, esiste un livello di accesso che i vendor delle principali piattaforme di acquisizione full file system utilizzano per estrarre dati che nessuna procedura di backup logico può raggiungere: le chat cancellate, i keychain, i database SQLite delle app di terze parti, i file di configurazione, gli attributi di sistema.
Per gli iPhone dotati di SoC dalla famiglia A11 in giù, la porta d’ingresso a questo livello passa da una vulnerabilità hardware immutabile presente nella BootROM Apple. Per l’A12 – il chip degli iPhone XS, XR e delle prime generazioni di iPad Pro 2018 – la vulnerabilità esiste, ma la sua catena di sfruttamento è considerevolmente più complessa.
Il team Forenser ha recentemente ricostruito la prima parte di questa catena su un iPhone XS di test. In questo articolo raccontiamo cosa siamo riusciti a fare, quale metodologia abbiamo seguito, quale contesto internazionale si sta muovendo intorno a questo genere di ricerca e – soprattutto – cosa questo apre in termini di prospettive per l’acquisizione forense di dispositivi mobili di generazione recente.
Il punto di partenza: BootROM e checkm8
Ogni iPhone, all’accensione, esegue un piccolo pezzo di codice fisicamente scritto sul silicio del processore: la BootROM. È il primo software che gira sul dispositivo, letteralmente immutabile perché scolpito nel chip durante la fabbricazione. Non può essere aggiornato con un aggiornamento di iOS; non può essere modificato nemmeno da Apple. Se contiene un difetto, quel difetto resta lì per tutta la vita del dispositivo.
Nel 2019 il ricercatore axi0mX ha pubblicato checkm8, un exploit che sfrutta proprio una vulnerabilità nella BootROM di tutti gli SoC Apple dall’A5 all’A11. Da allora, checkm8 è diventato la base di tutti i principali strumenti di jailbreak permanente (checkra1n, palera1n) e delle metodologie forensi impiegate dai vendor commerciali per l’acquisizione full file system. Nulla di ciò che Apple ha rilasciato successivamente – nemmeno le patch di iOS 18 – può neutralizzarlo su quei dispositivi.
Nota importante: la vulnerabilità nella BootROM non è risolvibile a livello di hardware perché il codice è fisicamente immutabile. Apple può tuttavia introdurre, nelle release successive di iOS, mitigazioni a livello di kernel, iBoot, Secure Enclave e stack di boot che rendono lo sfruttamento pratico della vulnerabilità progressivamente più complesso – richiedendo catene di exploit più articolate per raggiungere gli stage successivi. La porta d’ingresso della BootROM resta quindi aperta in perpetuo, ma l’accesso effettivo ai dati sulle release iOS più recenti non è né automatico né immediato.
Gli iPhone XS/XR/iPad Pro 2018 utilizzano il SoC A12 (T8020). Sono affetti dalla stessa famiglia di vulnerabilità, ma con condizioni di sfruttamento diverse e considerevolmente più delicate. Per anni non è esistito uno strumento pubblico stabile che funzionasse su A12 con la stessa semplicità di checkm8 sui chip precedenti.
Il progetto usbliter
Alcuni mesi fa, il gruppo di ricerca Paradigm Shift ha pubblicato un progetto denominato usbliter (dal nome del suo componente principale, usbliter8): una catena di exploit simile a checkm8 specificamente adattata all’A12/A13, distribuita insieme al codice sorgente su GitHub e accompagnata da un articolo tecnico sul loro sito. Il progetto includeva:
Un firmware da caricare su un microcontrollore Raspberry Pi Pico, che si comportava come ponte USB tra PC e iPhone
Il codice dell’exploit vero e proprio, che sfrutta un difetto nel controller USB DWC2 della BootROM A12
Uno shellcode che, una volta iniettato, trasforma la modalità DFU standard dell’iPhone in una modalità pwned (PWND DFU), stato che espone capacità estese non altrimenti disponibili
Un ramdisk SSH precompilato per il boot successivo su versioni iOS meno recenti
Il progetto usbliter come appariva sul repository GitHub di Paradigm Shift prima della sua rimozione.
Nella giornata di ieri, 25 luglio 2026, l’intero materiale è stato rimosso: sia l’articolo pubblicato sul sito del gruppo, sia il repository GitHub. Le motivazioni non sono state comunicate pubblicamente ma è chiaro che le copie del codice sono rimaste disponibili presso chi le aveva già scaricate prima della rimozione.
L’articolo di Paradigm Shift che descriveva il progetto, così come appariva prima della rimozione avvenuta il 25 luglio 2026.
Oggi la pagina risulta rimossa e il contenuto non è più accessibile, come si può notare accedendo alla URL pubblica precedentemente linkata in numerosi articoli.
La medesima pagina sul sito Paradigm Shift, non più raggiungibile.
L’exploit riuscito sul nostro iPhone XS
Per verificare quanto riportato nell’articolo, il team Forenser ha condotto l’attività di ricerca su un iPhone XS utilizzato ai fini di studio (identificativo hardware iPhone11,2 D321AP) con installato iOS 18.7.9, la versione piu recente disponibile al momento della verifica. La documentazione del progetto usbliter raccomandava esplicitamente l’uso di un Raspberry Pi Pico 2 – la seconda generazione del microcontrollore – motivando la scelta con maggiore stabilità dell’exploit e possibilità di supportare timing più aggressivi.
Nell’articolo sul sito web – ora rimosso – erano segnalati come compatibili anche altri microcontrollori di fascia analoga (RP2040 su schede alternative, alcune varianti STM32).
Raspberry pi pico utilizzato per testare l’exploit usbliter8
Nel nostro caso, nell’attesa della consegna di un microcontrollore tra i segnalati, avevamo a disposizione soltanto un Pi Pico di prima generazione (Pico 1 W, basato su RP2040). I primi tentativi di exploitation non davano esito: il dispositivo non transitava in stato PWND DFU e il descrittore USB restituito da libirecovery non mostrava la stringa PWND:[usbliter8] che avrebbe confermato la riuscita dell’exploit. Dopo alcuni cicli di verifica sul timing dei segnali e sui parametri del firmware caricato sul Pico, l’exploit ha iniziato a funzionare in modo affidabile anche sull’hardware di prima generazione.
Il descrittore USB dell’iPhone XS con l’exploit checkm8/usbliter8 attivo. La presenza della stringa PWND:[usbliter8] a fianco del tag SRTG:[iBoot-3865…] (identificativo della BootROM A12) conferma il buon esito dell’iniezione. Il codice ECID è stato oscurato per motivi di privacy.
Il risultato è stato positivo su prima generazione, ma segnaliamo che il Pico 2 resta la scelta preferibile per chi voglia partire da zero: la maggiore affidabilità dei timing riduce il numero di tentativi necessari.
Cosa significa “PWND DFU”: lo stage uno di un exploit BootROM
Un exploit BootROM completo si compone di più stage eseguiti sequenzialmente: ciascuno prepara le condizioni per il successivo, e ciascuno rappresenta un livello di accesso incrementalmente più profondo. Lo stage inizialmente ottenuto – quello che abbiamo raggiunto sul nostro iPhone XS con usbliter – è lo stage uno, ed è il più importante dell’intera catena.
In termini astratti, uno stage uno di exploit BootROM è il punto in cui l’attaccante – o il ricercatore, o l’operatore che utilizza uno strumento di acquisizione forense – ha già iniettato il proprio codice di controllo nella BootROM del dispositivo, prima ancora che qualsiasi componente del sistema operativo venga caricato. Da questa posizione:
La catena di firma Apple è aggirabile dallo stage successivo: si può caricare un iBoot personalizzato, un kernel modificato, un ramdisk arbitrario, purché si conoscano i passaggi tecnici corretti
Le protezioni introdotte da iOS sono ininfluenti, perché nessun componente di iOS è ancora stato eseguito: né AMFI, né Secure Enclave in modalità produzione, né i controlli TXM (Trusted Execution Monitor) introdotti nelle versioni più recenti
Il device è in uno stato “tethered”: ogni operazione richiede il PC e la catena di boot personalizzata, senza modifiche persistenti alla memoria flash del dispositivo se non esplicitamente volute – condizione fondamentale per la preservazione della prova digitale in ambito forense
Non è un caso che questo genere di accesso sia impiegato dalle piattaforme di acquisizione full file system utilizzano internamente per estrarre i dati dagli iPhone di generazione compatibile. La differenza tra un vendor commerciale (che vende la soluzione a decine di migliaia di euro per licenza annua) e un ricercatore che documenta lo stesso stage è solo l’ingegneria – non l’informazione tecnica di base, che è ampiamente disponibile nella letteratura di sicurezza pubblica sin dal 2019 (CVE-2019-8900 – Apple Security Advisories).
Il valore dello stage uno non risiede tanto in quello che permette di fare da solo – il device connesso in PWND DFU non fornisce ancora accesso ai dati utente – quanto nel fatto che rende possibile ogni stage successivo. Da questa posizione, con il tempo e la competenza necessari, si può in linea di principio arrivare a:
Il caricamento di un iBEC (iBoot Extended Console) personalizzato, in grado di accettare firmware non firmato da Apple
Il boot di un kernel iOS modificato per disattivare i controlli di integrità
Il montaggio di un ramdisk contenente strumenti di estrazione dati (SSH, tar, sqlite, keychain dumper)
L’accesso completo al file system del dispositivo, sia partizione di sistema che dati utente, incluse le sezioni normalmente cifrate dopo il primo unlock
L’estrazione delle chiavi crittografiche del keychain
È lo stesso schema che, con implementazioni diverse, viene utilizzato da anni per gli iPhone con SoC A7-A11. Portarlo alla generazione A12 è la sfida attualmente aperta.
Il panorama internazionale
La ricerca in questo ambito è in fermento. Nella medesima giornata in cui Paradigm Shift rimuoveva il proprio progetto, è comparso su GitHub un nuovo repository — usbliter8-fun a cura dell’utente 34306 — che documenta una catena analoga per iPhone 11 Pro (SoC A13 T8030) su iOS 27 beta. Il progetto include patch per iBSS, iBEC, kernel e TXM, oltre a un TSS proxy per la personalizzazione dei firmware tramite blob salvato.
Il repository 34306/usbliter8-fun su GitHub, che documenta una catena di exploit funzionante su iPhone 11 Pro con iOS 27 beta. Un progetto strutturalmente affine al nostro caso, con adattamenti specifici per l’A13 e il firmware corrente della beta pubblica.
Il progetto 34306 non è direttamente riutilizzabile sul nostro iPhone XS: l’A13 e l’A12 hanno offset diversi, e iOS 27 introduce nuove strutture crittografiche assenti in iOS 18, ma conferma che l’approccio è valido e che la comunità di ricerca sta attivamente lavorando su queste piattaforme.
Il repository resta pubblicamente accessibile al momento della pubblicazione di questo articolo. Il codice è distribuito con avvertimenti espliciti sui rischi di corruzione del Secure Enclave, del passcode, delle credenziali WiFi e del baseband: motivo per cui – come per ogni operazione di questo tipo – la ricerca deve essere condotta esclusivamente su dispositivi dedicati e mai su device operativi.
Prospettive per l’acquisizione forense
Se e quando la catena sarà completa sul nostro laboratorio, le possibilità applicative in ambito forense sono considerevoli. Un iPhone XS con ultima versione di iOS installata, rappresenta ancora una porzione significativa dei dispositivi che entrano regolarmente nei nostri casi come oggetto di analisi. Le capacità che uno stage completo abiliterebbe includono:
Acquisizione full file system senza dipendere da tool commerciali di terze parti, con la possibilità di documentare integralmente ogni passaggio della procedura
Estrazione del keychain e delle credenziali applicative, oggi non ottenibili con backup logico via libimobiledevice
Recupero di chat cancellate e altri artefatti disponibili solo dai database SQLite completi, non nella loro versione backup
Analisi live del dispositivo in modalità tethered per ricerca di malware persistente, con visibilità sul filesystem, sui processi e sui log a livelli non altrimenti raggiungibili
Preservazione della prova con controllo totale sui passaggi eseguiti e ripetibilità dell’operazione documentabile
Non è un obiettivo alla portata di ogni operatore, e non lo è ancora nemmeno per noi in questo momento: siamo alla prima porta della catena, con davanti diversi stage da consolidare. Ma la strada è tracciata, e la letteratura disponibile – sia quella pubblica sia quella oggi rimossa ma già distribuita – è sufficiente per proseguire.
Considerazioni finali
Il team Forenser sta proseguendo – ovviamente per fini accademici e scientifici – l’attività di ricerca sui stage successivi per verificare quali sono le vulnerabilità dei sistemi e le potenzialità in ambito informatico forense.
Ogni progresso viene documentato internamente con criteri di riproducibilità che riteniamo essenziali quando si opera in ambito forense: nessun passaggio deve essere frutto di tentativi non tracciabili, nessuna patch deve essere applicata senza comprenderne il razionale, nessun test deve avvenire su dispositivi che non siano stati preventivamente designati come sacrificabili per la ricerca.
Il valore di questa attività non risiede in un jailbreak per finalità di modifica del dispositivo – ambito su cui non operiamo – ma nella comprensione tecnica di uno strato del sistema iOS che è pubblicamente documentato ma poco praticato al di fuori dei vendor commerciali.
Comprendere direttamente come funziona lo stage BootROM di un iPhone A12 significa poter valutare, in casi reali, la qualità delle acquisizioni prodotte da terzi, individuare eventuali artefatti introdotti dagli strumenti utilizzati e – nei casi in cui sia strettamente necessario – condurre l’acquisizione in modo indipendente, con piena documentazione tecnica della catena di custodia digitale.
Aggiorneremo il nostro sito con i risultati man mano che i vari stage saranno consolidati.
Nel corso della lezione del 23 maggio 2026 del I Corso Biennale di Specializzazione dell’Avvocato Penalista, organizzato dalla Scuola UCPI di Roma, il Prof. Avv. Marco Pittiruti e il consulente informatico forense e CEO Forenser Dr. Paolo Dal Checco hanno affrontato uno dei temi oggi più delicati del processo penale: la gestione della prova digitale, con particolare riferimento alle perquisizioni e ai sequestri probatori informatici.
L’incontro ha messo in evidenza come l’evoluzione tecnologica abbia profondamente modificato il modo di svolgere le indagini penali. Smartphone, computer, cloud, account online e sistemi di messaggistica rappresentano ormai archivi completi della vita personale e professionale di ogni individuo. Di conseguenza, ogni attività di acquisizione forense comporta inevitabilmente un impatto molto significativo sui diritti fondamentali della persona sottoposta a indagine.
La prova digitale non è una “prova perfetta”
Nel suo intervento introduttivo, il Prof. Marco Pittiruti ha evidenziato come una parte della giurisprudenza abbia per lungo tempo considerato la prova digitale quasi come una prova “autoevidente”, affidabile per definizione e quindi assimilabile a un semplice documento ai sensi dell’art. 234 c.p.p.
Secondo Pittiruti, questa impostazione è ormai superata. Il dato informatico presenta infatti caratteristiche peculiari: è immateriale, facilmente alterabile, duplicabile e spesso estremamente promiscuo, poiché all’interno dello stesso dispositivo convivono informazioni personali, professionali e dati potenzialmente rilevanti per l’indagine.
Da qui nasce il problema centrale affrontato durante la lezione: come conciliare le esigenze investigative con il rispetto del diritto di difesa e del principio di proporzionalità?
Il problema dei sequestri “omnibus”
Uno dei passaggi più significativi dell’intervento ha riguardato il fenomeno dei sequestri “omnibus”, ossia quei provvedimenti con cui vengono acquisiti integralmente computer, smartphone, server o interi archivi digitali senza una preventiva delimitazione dei dati realmente pertinenti all’indagine.
Pittiruti ha osservato come l’attività di sequestro informatico rischi di trasformarsi in vere e proprie “pesche a strascico investigative”, nelle quali il pubblico ministero ottiene accesso indiscriminato a enormi quantità di informazioni, spesso estranee al procedimento penale. Questo problema è particolarmente rilevante perché i moderni dispositivi elettronici contengono ormai l’intera vita digitale dell’individuo: comunicazioni private, dati sanitari, fotografie, attività lavorative, credenziali di accesso, relazioni professionali e informazioni riservate.
Secondo il relatore, il principio di proporzionalità rappresenta oggi il principale strumento difensivo per contrastare queste prassi investigative. La Corte di Cassazione, soprattutto nelle pronunce più recenti, ha progressivamente imposto al pubblico ministero un obbligo di motivazione rafforzata, richiedendo che il decreto di perquisizione e sequestro specifichi in modo concreto:
quali dati si intendono cercare;
perché sia necessario acquisire determinati dispositivi;
quali criteri di selezione verranno utilizzati;
quale sia il periodo temporale rilevante per l’indagine.
L’importanza delle parole chiave e dei criteri di selezione
Particolare attenzione è stata dedicata ai criteri di selezione dei dati, spesso realizzati mediante parole chiave utilizzate durante le attività di analisi forense. Pittiruti ha sottolineato come la giurisprudenza più recente richieda che tali criteri siano “effettivi” e non meramente apparenti.
Un esempio concreto citato durante la lezione riguarda l’utilizzo del nome di un’azienda o del dominio di posta elettronica come keyword di ricerca: una scelta apparentemente neutra che, in pratica, può comportare il sequestro indiscriminato di migliaia di email e documenti.
Il tema assume ulteriore rilevanza quando nei dispositivi sequestrati sono presenti comunicazioni coperte da segreto professionale, come quelle tra avvocato e assistito. Pittiruti ha evidenziato come, nella prassi, non sempre vengano adottate adeguate cautele per evitare l’acquisizione di tali contenuti, con il rischio di compromettere il diritto di difesa.
Copia di mezzo e copia di fine
Entrambi I relatori hanno ampiamente parlato della questione legata alla nuova normativa che prevede la creazione di una copia forense che viene identificata inizialmente come “copia di mezzo” o “copia mezzo” e poi, successivamente alla creazione e consolidamento, filtrata tramite selezione basata su keyword (parole chiave), criteri temporali, criteri di contesto o valori hash producendo quella che si definisce “copia di mezzo” o “copia mezzo”.
Nel contesto delle indagini digitali e del diritto processuale penale, la copia-mezzo è infatti la copia integrale e non selettiva di tutti i dati presenti su un dispositivo sequestrato, una copia completa e comprensiva di tutti i dati appresi, inclusi in buona parte dati fuori dal perimetro dell’indagine.
Da questa, gli inquirenti, Polizia Giudiziaria o i consulenti tecnici forensi appositamente nominati dal Pubblico Ministero selezionano solo le informazioni rilevanti al reato, creando così la copia-fine, che entra ufficialmente a far parte del fascicolo probatorio.
La distinzione è fondamentale per tutelare la privacy e il diritto di difesa del cittadino ed è regolamentata in modo preciso: Copia-mezzo (Copia Integrale o Servente) è il duplicato esatto (bit-a-bit) dell’intero dispositivo (es. smartphone, PC) e la sua funzione è tecnica è quella di cristallizzare tutto il contenuto per consentire la restituzione del dispositivo fisico all’avente diritto nel minor tempo possibile. La Copia-fine (Copia Selettiva) è invece l’insieme di dati estratto dalla copia-mezzo che contiene esclusivamente le informazioni pertinenti alle indagini, tanto che solo questi file specifici costituiranno la prova utilizzabile in giudizio.
I concetti di copia-mezzo e copia-fine non derivano da una specifica legge o articolo del codice, ma dalla giurisprudenza della Corte di Cassazione: i Giudici hanno provveduto a colmare un vuoto normativo per adattare le vecchie regole sul sequestro fisico all’era degli smartphone e dei computer. Poiché il codice di procedura penale non menziona esplicitamente i termini “copia di mezzo” e “copia di fine”, la Sentenza della Corte di Cassazione n. 34265 del 22 settembre 2020 (depositata il 2 dicembre 2020) ne ha formalizzato la distinzione e le regole d’uso:
La durata del sequestro e la “vita digitale” dell’indagato
Un altro aspetto affrontato riguarda la durata del sequestro dei dispositivi informatici. Nella pratica investigativa capita frequentemente che smartphone e computer vengano trattenuti per mesi, talvolta anni, con pesanti ripercussioni sulla vita personale e professionale dell’indagato.
La Corte di Cassazione ha progressivamente affermato che il trattenimento dei dati e delle copie forensi deve limitarsi al tempo strettamente necessario alle operazioni di selezione e analisi. Tuttavia, come osservato durante la lezione, nella pratica questo principio si scontra con criteri molto elastici e con l’ampia discrezionalità riconosciuta agli organi investigativi.
La gestione tecnica del reperto informatico
Nella seconda parte dell’incontro, il CEO Forenser Paolo Dal Checco ha affrontato – dal punto di vista del perito informatico forense – gli aspetti tecnici dell’informatica forense, illustrando le metodologie utilizzate per acquisire e analizzare correttamente i dati digitali tramite tecniche di digital forensics.
L’intervento ha evidenziato come l’acquisizione forense non possa essere improvvisata: anche una semplice operazione di collegamento di un dispositivo a un computer può alterare automaticamente i dati presenti sul supporto. Dal Checco ha spiegato che i sistemi operativi moderni eseguono frequentemente operazioni automatiche – come la creazione di file di sistema, la modifica di timestamp o l’indicizzazione dei contenuti – che possono compromettere l’integrità del reperto digitale.
Per questo motivo, nella digital forensics vengono utilizzati strumenti specifici, come i write blocker hardware e software, che impediscono al sistema operativo di scrivere accidentalmente sui supporti sequestrati.
Dal Checco ha inoltre illustrato le differenze operative tra Windows, macOS e Linux nella gestione dei dispositivi acquisiti, evidenziando come alcuni sistemi offrano maggiori garanzie rispetto ad altri nella prevenzione delle alterazioni involontarie dei dati.
Le best practices e la genuinità della prova
Uno dei punti centrali dell’intervento tecnico ha riguardato il rispetto delle best practices internazionali di digital forensics. La corretta acquisizione del dato richiede infatti:
documentazione completa delle operazioni;
utilizzo di strumenti verificati;
generazione di hash crittografici;
tracciabilità delle attività svolte;
conservazione sicura delle copie forensi;
possibilità di ripetere e verificare le operazioni eseguite.
Sul piano giuridico, Pittiruti ha evidenziato come la violazione di queste procedure non venga ancora considerata dalla giurisprudenza italiana come causa automatica di inutilizzabilità della prova. Tuttavia, alcune recenti pronunce sembrano aprire scenari nuovi, attribuendo crescente importanza alla correttezza metodologica delle operazioni tecniche e alla verifica dell’attendibilità intrinseca della prova digitale.
Il ruolo sempre più centrale del consulente informatico forense
Uno dei messaggi più forti emersi durante la lezione è stato il ruolo ormai imprescindibile del consulente informatico forense nella strategia difensiva.
Secondo entrambi i relatori, oggi non è più sufficiente una difesa esclusivamente giuridica: la comprensione delle metodologie tecniche di acquisizione, conservazione e analisi del dato è diventata essenziale per verificare la legittimità dell’attività investigativa e individuare eventuali anomalie o violazioni.
Il processo penale digitale richiede quindi una collaborazione sempre più stretta tra avvocato e consulente tecnico, affinché il contraddittorio possa svilupparsi non solo sul piano giuridico, ma anche su quello scientifico e metodologico.
Una sfida centrale per il processo penale contemporaneo
La lezione ha mostrato con grande chiarezza come il tema della prova digitale rappresenti oggi una delle principali sfide del processo penale contemporaneo. L’enorme capacità invasiva degli strumenti informatici impone infatti un delicato equilibrio tra esigenze investigative e tutela dei diritti fondamentali.
Da un lato vi è la necessità di acquisire prove spesso decisive; dall’altro emerge sempre più chiaramente il rischio che attività investigative sproporzionate compromettano la riservatezza, il diritto di difesa e la genuinità stessa della prova.
In questo scenario, la digital forensics non rappresenta soltanto una disciplina tecnica, ma diventa uno strumento essenziale di garanzia processuale.
Un weekend tranquillo, di fine maggio: il tempo passa senza problemi fino a quando non iniziano ad arrivare messaggi ambigui sull’applicazione di WhatsApp installata sul tuo iPhone. I contatti iniziano a chiederti: “perché devo darti dei soldi?” oppure “a cosa ti serve il bonifico?”. Questi contatti stanno solo rispondendo ad un messaggio che è stato inviato dal tuo account WhatsApp; il problema è che tu non hai inviato nulla.
Questo è ciò che è accaduto negli ultimi giorni a diverse persone che si sono rivolte al nostro studio. Siamo stati contattati in più occasioni, nell’arco della stessa giornata, da utenti che avevano riscontrato la medesima anomalia. Il fatto curioso è che nessun dispositivo estraneo risultava associato all’account WhatsApp personale: la sezione “Dispositivi collegati” (“Linked Devices”) era pulita, eppure qualcuno stava inviando messaggi a nostra insaputa, dal nostro numero. Cosa sta succedendo?
A questo punto sono iniziate le nostre indagini per cercare di capire come sia possibile incorrere in una “problematica” di questo tipo. Quanto raccolto ha permesso di rivelare dei pattern comuni, utili per contestualizzare il tipo di minaccia e la superficie di attacco.
Confronto tra i casi
Mettendo a confronto i diversi casi raccolti, abbiamo individuato una serie di elementi ricorrenti che delineano lo scenario di compromissione:
• tutti i casi rilevati riguardano iPhone (dal modello 8 al 14, incluse le varianti X, XR, XS, 11, SE, 12 e 13) su cui è installata un versione di iOS 16 nelle sue diverse release;
• gli attaccanti scrivono in chat ai contatti della vittima, dal numero WhatsApp della vittima stessa, chiedendo di disporre bonifici;
• gli attaccanti sembrano avere accesso alle sole chat recenti, ovvero a quelle con cui la vittima ha interagito da poco;
• nessun dispositivo collegato è visibile nella sezione “Dispositivi collegati” delle impostazioni di WhatsApp;
• le vittime non riportano di aver compiuto alcuna azione di pairing particolare: non hanno fornito codici, non hanno inquadrato QR code, non hanno autorizzato accessi.
Per queste ragioni è stato sin da subito evidente che non si trattasse di un classico episodio di ghost pairing (nel quale l’attaccante induce la vittima a scansionare un QR code o a condividere un codice di verifica): l’assenza di qualsiasi interazione richiesta all’utente fa propendere per una compromissione di tipo 0-click, cioè per un’infezione che non richiede alcun intervento da parte della vittima e che colpisce direttamente lo smartphone o l’app WhatsApp.
Account Fantasma
Il primo aspetto senza dubbio interessante è la mancanza di un dispositivo associato. Analizzando i log di una delle copie forensi e il relativo sysdiagnose (componente del sistema operativo iOS contenente i log di diagnostica del telefono), è stato possibile notare un’anomalia nei log generati da WhatsApp: una continua sequenza di eventi di “resync”, come se l’applicazione stesse continuamente rinegoziando la sessione con i server di WhatsApp. Si tratta di eventi non molto comuni presenti in quantità insolita, a meno che qualcun altro non stia tentando in parallelo di mantenere attiva una propria sessione sullo stesso account.
Questa sequenza continua di sincronizzazione, di fatto, è il sintomo di una “competizione” tra due endpoint che cercano di mantenere attiva la stessa sessione, dinamica che approfondiremo successivamente, dopo aver discusso del probabile vettore di compromissione.
Versione di iOS
Un secondo aspetto molto interessante è che tutte le persone che ci hanno contattato possiedono un iPhone, con una specifica versione: iOS 16. Che sia questo il comune denominatore?
Partendo da tale presupposto abbiamo approfondito, ricercando tra i vari articoli presenti in rete e tra i log a disposizione, presenti tra i dati dei dispositivi compromessi. Ricercando problematiche di sicurezza correlate ad iOS 16 abbiamo notato una vulnerabilità descritta nel CVE-2025-43300, possibilmente in combinazione con il CVE 2025-55177 (vulnerabilità di WhatsApp iOS/macOS che poteva consentire il parsing di contenuti da URL arbitrari tramite messaggi di sincronizzazione dei dispositivi collegati non correttamente autorizzati):
La vulnerabilità identificata pare sia correlata al processo delle immagini da parte di una libreria del sistema operativo, libreria utilizzata da diverse applicazioni come, appunto, WhatsApp. In aggiunta, nelle ultime settimane, la letteratura online in relazione a questa vulnerabilità sembra sia stata ampiamente documentata, rendendo di conseguenza più facile lo sfruttamento. Stando a quanto riportato dalla descrizione della vulnerabilità, le versioni di iOS minori della 16.7.12 sembrano essere vulnerabili, versioni compatibili con quelle da noi rilevate nei dispositivi delle vittime.
A supporto di questa tesi, all’interno degli unified logs estratti dal dispositivo sono state rinvenute molteplici occorrenze di errori generati proprio dalla libreria che si occupa del parsing delle immagini, in orari compatibili con quelli relativi alla compromissione degli account WhatsApp.
Riproduzione dello scenario in laboratorio
Per chiudere il cerchio attorno alla sequenza anomala di “resync” osservata nei log, i nostri tecnici hanno provato a riprodurre in laboratorio una parte dello scenario di compromissione, impiegando un device di “test” con installata una versione di iOS vulnerabile. L’attività ha permesso di confermare che esiste effettivamente una catena di azioni in cui un dispositivo estraneo si presenta al server di WhatsApp, apparendo come il dispositivo “vittima”. In tale condizione non vi è alcun tipo di avviso su quest’ultimo da parte di WhatsApp o di iOS.
In altre parole, partendo dal dispositivo compromesso è possibile esfiltrare il materiale crittografico utile per l’handshake di avvio sessione, necessario per istanziare un nuovo client WhatsApp altrove, agganciato però all’account della vittima. È proprio in questa fase che si genera la sequenza continua di “resync” nei log (riscontrati parimenti nei test del nostro laboratorio): il telefono legittimo e il client dell’attaccante si contendono la sessione, riautenticandosi ciclicamente sui server di WhatsApp. Questo modello operativo è pienamente coerente con quanto raccolto sul campo, ovvero con un account che invia messaggi a contatti recenti pur in totale assenza di dispositivi collegati visibili dalle impostazioni dell’app.
Indicazioni operative per utenti e vittime
Sulla base di quanto osservato sui casi reali e di quanto verificato durante la riproduzione dello scenario, possiamo proporre alcune indicazioni pratiche, fermo restando che l’analisi è tuttora in corso e che gli aggiornamenti potranno modificare il quadro qui descritto.
In ottica di prevenzione, trattandosi presumibilmente di un attacco 0-click, è utile ridurre la superficie d’attacco limitando gli automatismi e attivando la Lockdown Mode tramite le Impostazioni Restrittive dell’Account (Strict Account Settings). Non abbiamo ancora verificato se l’abilitazione della verifica in due passaggi su WhatsApp riduca concretamente il rischio di compromissione, ma resta una buona pratica generale. La raccomandazione principale rimane comunque l’aggiornamento del sistema operativo all’ultima patch di sicurezza disponibile: nei casi raccolti, tutti i dispositivi vulnerabili eseguivano una release di iOS 16, mentre la vulnerabilità CVE-2025-43300 risulta corretta nelle versioni successive (quantomeno per gli iPhone).
Se l’account risulta già compromesso, dalle osservazioni condotte emergono alcuni elementi utili: utilizzando il blocco delle chat (la funzione che le rende nascoste tramite codice o biometria) gli attaccanti sembrano non riuscire più a leggerle né a scrivere ai relativi contatti; per “estromettere” l’attaccante pare efficace aggiornare l’app WhatsApp o installarla su un nuovo dispositivo procedendo a una nuova autenticazione; infine, dato che tutti i casi raccolti riguardano dispositivi con iOS 16, l’aggiornamento del sistema operativo dovrebbe far venire meno le condizioni di sfruttamento dell’infezione.
Una raccomandazione importante per chi riceve messaggi sospetti: se un contatto chiede l’esecuzione di un bonifico via WhatsApp, è preferibile verificare la richiesta con una telefonata diretta. Scrivere alla vittima sulla stessa chat WhatsApp potrebbe non essere efficace, perché i messaggi potrebbero essere visualizzati dall’attaccante senza arrivare al legittimo titolare dell’account.
Chiaramente, dal punto di vista delle indagini e della preservazione delle prove, il consiglio di massima è rivolgersi ad un team esperto che possa fornire consigli più approfonditi, idonei per ogni caso specifico, auspicando al contempo la possibilità di non perdere prove utili per futuri approfondimenti.
Il nostro team sta proseguendo le attività di analisi, raccogliendo ulteriori copie forensi e verificando in dettaglio il modello di attacco. Nel frattempo, la raccomandazione operativa più rilevante resta quella di aggiornare la propria versione di iOS con l’ultima patch di sicurezza disponibile, così da ridurre notevolmente le probabilità di infezione.
È stata recentemente rilasciata DRIFT Linux, una nuova distribuzione italiana per la Digital Forensics, ideata da Massimiliano Dal Cero e basata su Ubuntu 24.04 LTS (Noble). Il progetto si propone come ambiente operativo pensato per le attività forensi sul campo.
Allo stato attuale, DRIFT è concepita principalmente come sistema live avviabile da chiavetta USB, mentre eventuali soluzioni installabili sono previste per versioni successive. Dalla pagina di download emerge inoltre una struttura già piuttosto chiara del progetto: sono disponibili le varianti DRIFT Fast 2026.01 e DRIFT Fast XS 2026.01, mentre Fast Micro e una versione installabile denominata Paddock risultano annunciate come prossime. Questo lascia intendere una distribuzione pensata non come immagine unica, ma come famiglia di strumenti destinata a differenziarsi in base ai diversi scenari operativi.
Secondo quanto riportato sul sito ufficiale, DRIFT Linux si presenta come un ambiente operativo orientato all’uso sul campo, con particolare attenzione alla preservazione delle evidenze digitali, alla gestione controllata dei dispositivi collegati e alla disponibilità immediata di strumenti utili nelle fasi di acquisizione e prima analisi. Abbiamo avuto modo di testarla nei primi giorni successivi al rilascio: in questo articolo ne riportiamo alcune caratteristiche tecniche, soffermandoci sulle principali fasi operative dei moduli esaminati.
Cos’è una distribuzione Linux forense e perché si usa
Una distribuzione Linux forense è un sistema operativo progettato per svolgere attività di acquisizione e analisi cercando di preservare, per quanto possibile, l’integrità dei dati originali. Spesso viene eseguita in modalità live, ad esempio da chiavetta USB, così da ridurre l’interazione con il sistema oggetto di esame e operare in un ambiente controllato.
A differenza di un sistema operativo generico, una distro forense integra di norma strumenti e accorgimenti pensati per limitare le alterazioni indesiderate: accesso ai supporti in sola lettura, gestione controllata delle connessioni, produzione di log e raccolta tracciabile delle evidenze. Questo approccio riduce il rischio di contaminazione accidentale dei dati e contribuisce a rafforzare l’integrità, la tracciabilità e la verificabilità tecnica delle evidenze digitali.
Le caratteristiche di DRIFT Linux che abbiamo testato
Secure Boot Ready
Un aspetto emerso sin da subito nel corso dei test riguarda la compatibilità con il sistema di protezione Microsoft Secure Boot. DRIFT Linux si presenta infatti come una distribuzione avviabile anche su sistemi con Secure Boot abilitato, senza richiedere la disattivazione dell’opzione nel BIOS/UEFI. Si tratta di una semplificazione operativa concreta, soprattutto quando si interviene su hardware moderno o in contesti aziendali nei quali modificare le impostazioni di sicurezza potrebbe non essere possibile, consentito o comunque opportuno.
Kernel Write Blocker nativo
Uno degli aspetti più interessanti di DRIFT Linux è il kernel write blocker nativo visibile all’interno dell’applicativo DRIFT Mount Manager. La protezione dell’integrità dei dati è infatti gestita a livello kernel: i dispositivi collegati vengono mantenuti in sola lettura per impostazione predefinita fin dalle prime fasi del boot, riducendo al minimo il rischio di alterazioni accidentali dei supporti originali. Qualora sia necessario abilitarne la scrittura, l’operazione richiede comunque un’azione esplicita da parte dell’operatore, accompagnata da un avviso ben visibile come da immagine sottostante:
DRIFT Mount Manager — Kernel Write Blocker ATTIVO con dialog di sblocco
Connection Panel
Il Connection Panel è un’interfaccia grafica dedicata che consente di visualizzare e gestire in modo diretto lo stato dei servizi di rete. Si tratta di una scelta coerente con quanto indicato dal progetto, che presenta la connettività come una componente da attivare consapevolmente, così da ridurre il rischio di interferenze o alterazioni del contesto tecnico durante le attività di acquisizione e analisi iniziale. Dal punto di vista operativo, questa impostazione appare particolarmente utile perché sposta il controllo verso l’operatore: la rete non viene trattata come una funzione sempre attiva in background, ma come un elemento da governare in modo esplicito in base alle esigenze del caso concreto.
Estratto del Connection Panel
Drift Forensics Web Acquire
Tra i moduli più interessanti della distribuzione figura Web Acquire. Automatizza l’intera catena di acquisizione forense di una pagina web: snapshot della configurazione di rete (IP, routing, DNS), traceroute verso host multipli, cattura PCAP del traffico, esportazione SSL Key Log dal browser per la decifratura HTTPS, registrazione schermo sincronizzata in formato MP4, generazione del valore di hash SHA-256 di tutti i file prodotti e marcatura temporale blockchain tramite OpenTimestamps.
Le schermate dei test mostrano un’interfaccia dedicata, denominata Drift Forensics Web Acquire, nella quale compaiono campi strutturati per nome del caso, numero del caso, analista, pagina iniziale e destinazione. L’impressione è quella di un workflow pensato non soltanto per “salvare” una pagina web, ma per documentare in modo più ampio il contesto tecnico dell’attività svolta.
Estratto del pannello Drift Forensics Web Acquire
Al termine dell’attività viene generato automaticamente un report HTML completo, di cui vengono mostrati due estratti immagine:
Estratti del report HTML prodotto a fine acquisizione web
Guymager
Tra gli strumenti inclusi in DRIFT Linux figura Guymager 0.8.13, impiegato per l’acquisizione forense di supporti fisici.
Per procedere, è necessario aprire il software “DRIFT Mount Manager”, individuare il disco di destinazione e disattivarne il blocco in scrittura tramite l’icona del lucchetto posta accanto al nome del supporto. Successivamente, il dispositivo dovrà essere impostato in modalità “RW”, così da renderlo idoneo a ricevere i file prodotti durante l’acquisizione forense.
Di seguito si riportano alcune schermate relative al test effettuato:
Dopo aver selezionato “Procedi”, a schermo vengono indicati il percorso del dispositivo sbloccato in RW (/dev/sdc1) e la destinazione (/media/drift/RIPRISTINO):
Premendo nuovamente su “Procedi”, viene mostrato il percorso di mount del disco, ovvero in “/media/drift/RIPRISTINO”:
Estratti di DRIFT Mount Manager
Prima di avviare l’acquisizione, Guymager consente di compilare i metadati del caso — numero del caso, numero dell’evidenza, nome dell’esaminatore e note — che verranno associati all’immagine forense generata. Il software supporta i formati EWF/Exx e dd, con calcolo dell’hash in MD5, SHA-1 e SHA-256 e verifica finale dell’acquisizione, utile a confermare la corrispondenza bit-per-bit tra il supporto sorgente e la copia prodotta.
Nel campo Image directory, visibile nell’immagine sottostante, è stato indicato il percorso del supporto esterno precedentemente montato in modalità RW tramite DRIFT Mount Manager — in questo caso “/media/drift/RIPRISTINO” — con l’aggiunta della cartella di destinazione “Copia_F2026_TEST” prevista per il salvataggio dell’immagine forense.
Estratto dell’interfaccia di Guymager che mostra il completamento della copia (Finished)
Nel complesso, DRIFT Linux appare come un progetto che prova a coniugare funzioni dedicate e strumenti già noti nelle prassi di acquisizione forense, con un’impostazione orientata al controllo dell’ambiente operativo e alla preservazione delle evidenze. Pur trattandosi di una prima release, le funzionalità osservate nei test consentono già di coglierne alcuni aspetti di interesse.
Per ulteriori informazioni sul progetto, sulle funzionalità disponibili e sulla documentazione tecnica, è possibile consultare il sito ufficiale di DRIFT Linux: driftlinux.org