Il PDF di Schrödinger: stesso hash, due contenuti diversi

Nell’informatica forense, la PDF forensics si occupa dell’acquisizione e dell’analisi tecnica dei documenti PDF: struttura interna, immagini, metadati, revisioni, possibili manipolazioni e firme digitali. Anche l’esame delle firme rappresentate graficamente richiede di distinguere ciò che il documento contiene da ciò che viene mostrato sullo schermo.

Ci sono casi nei quali questa analisi diventa più complessa a causa di differenze di interpretazione o di rendering, dovute alla struttura del documento, al software utilizzato o alla loro interazione. Tali differenze possono anche essere sfruttate intenzionalmente da chi costruisce il PDF.

Ci siamo imbattuti in un PDF nel quale alcune immagini non comparivano in Anteprima (Preview) su macOS, pur essendo visibili con altri software. Al posto di alcune fotografie apparivano riquadri grigi; lo stesso documento, aperto con altri visualizzatori, mostrava invece le immagini.

L’indagine è partita dalle immagini della copertina: prima di considerarle mancanti o danneggiate, abbiamo verificato che fossero effettivamente presenti negli oggetti del PDF.

Attraverso una serie di test sempre più ridotti è stato possibile circoscrivere una differenza di comportamento alla gestione di particolari immagini JPEG 2000 con campi della File Type Box che dichiarano il formato JPX. Questa dichiarazione va distinta dalla piena conformità del container allo standard.

Il risultato è particolarmente interessante: abbiamo costruito due PDF che differiscono esclusivamente per due byte nell’intero file, con lo stesso codestream JPEG 2000. Nel test effettuato con PDFKit su macOS, una variante mostra l’immagine e l’altra produce una pagina bianca.

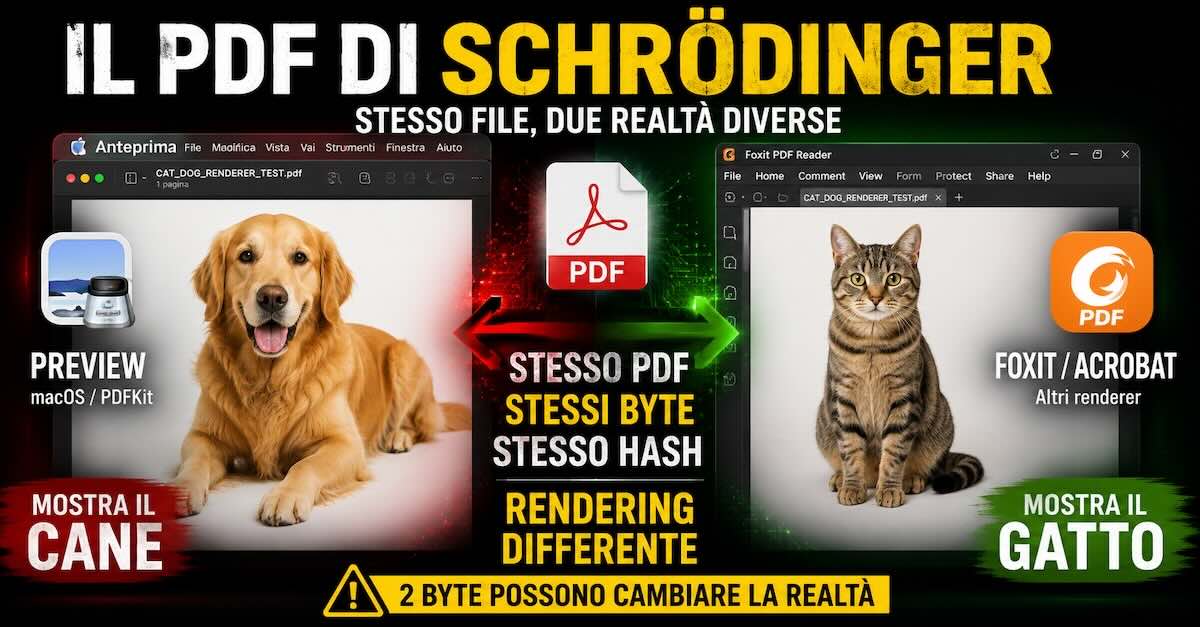
Abbiamo poi sfruttato la differenza di rendering per costruire un secondo esperimento: un solo PDF che mostra un cane con un renderer e un gatto con un altro. Il file non cambia; cambia la sua rappresentazione visiva.

La struttura del PDF e le immagini contenute

Per capire il problema bisogna innanzitutto distinguere il documento PDF dal modo in cui viene visualizzato.

Un PDF è un contenitore strutturato che può includere testo, font, grafica vettoriale, immagini raster, trasparenze, profili colore, maschere, livelli e numerosi altri oggetti. Quando apriamo il documento non stiamo necessariamente vedendo qualcosa di già “disegnato”: è il renderer PDF a interpretare quegli oggetti e a trasformarli nei pixel mostrati sul display.

Applicazioni differenti possono utilizzare motori differenti, mentre applicazioni diverse possono anche condividere lo stesso motore. Anteprima e altre applicazioni Apple utilizzano le tecnologie PDF del sistema; altri visualizzatori impiegano implementazioni differenti. Anche nel browser il risultato dipende dal componente che apre il PDF: per descrivere una prova servono quindi applicazione, versione e modalità di apertura, oltre al sistema operativo.

Un documento leggibile da un renderer può dunque evidenziare un limite, un errore o una diversa gestione dell’input in un altro. Il fatto che un software mostri l’immagine, da solo, non dimostra però che l’intero documento sia conforme alle specifiche.

Le immagini “scomparse” erano ancora dentro il PDF

Nel documento originario, gli Image XObject delle fotografie erano presenti, con dimensioni e stream apparentemente coerenti. Altri visualizzatori riuscivano a decodificarli e a mostrarli: l’assenza sullo schermo non corrispondeva all’assenza dei dati nel PDF.

Le sei immagini problematiche della copertina condividevano una caratteristica:

JPEG 2000 + CMYK + filtro PDF /JPXDecode.

Il filtro /JPXDecode, introdotto con PDF 1.5, è il meccanismo previsto per decodificare immagini JPEG 2000. Il suo nome non significa che ogni stream debba avere il brand jpx : lo stesso filtro è usato anche per immagini con container JP2. La specifica disciplina inoltre il rapporto tra le informazioni colore interne all’immagine e quelle dell’Image XObject.

La presenza di /JPXDecode, quindi, non costituisce di per sé un errore.

I formati JP2 e JPX

JPEG 2000 comprende una famiglia di specifiche. La Part 1 definisce il sistema di codifica principale e il formato JP2; la Part 2 introduce estensioni alla codifica e il formato JPX, con funzionalità aggiuntive per la descrizione del colore, più codestream e la composizione delle immagini. È essenziale distinguere il codestream compresso dal container che lo racchiude.

Un container JP2 è organizzato in box. Lo schema seguente descrive i quattro box di primo livello presenti anche negli stream del testcase; non è una descrizione completa dei requisiti di un JPX conforme. Un codestream JPEG 2000 privo di container, invece, non presenta questa struttura a box:

JPEG2000 Signature Box
File Type Box       (ftyp)
JPEG2000 Header     (jp2h)
Codestream          (jp2c)

La File Type Box (ftyp) contiene un brand principale, un valore di versione minore e una lista di compatibilità. Nell’analisi abbiamo confrontato la dichiarazione:

brand = "jpx "

con:

brand = "jp2 "

Analizzare il codestream JPEG 2000

Per distinguere le proprietà delle immagini da quelle del container abbiamo esaminato i marker del codestream. È importante separare le immagini del documento originario dal testcase sintetico distribuito qui: non sono lo stesso insieme di dati.

Nei due PDF definitivi del testcase, l’immagine è di 512 × 512 pixel, con quattro componenti a 8 bit, senza subsampling, e colore CMYK dichiarato nel PDF e nel box colr. Il codestream usa progression order LRCP, un solo quality layer, MCT=0, cinque livelli di decomposizione, code-block 64 × 64 e trasformata 5/3 reversibile, con stile di quantizzazione 0, senza quantizzazione. Questi parametri descrivono la coppia allegata, non necessariamente le fotografie del documento iniziale.

Nella coppia definitiva sono presenti, tra gli altri, i seguenti marker:

SOC
SIZ
COD
QCD
SOT
SOD
EOC

Il marker di commento COM, presente in una versione precedente con l’indicazione del software di codifica, è stato rimosso da entrambi i PDF definitivi. Questa pulizia è comune ai due file e non altera i dati compressi dei campioni dell’immagine.

Nelle prove preliminari, convertire l’immagine in JPEG tradizionale mantenendo DeviceCMYK ne consentiva la visualizzazione in Anteprima. Questo esclude un’incapacità generale di mostrare immagini CMYK, ma non esclude un’interazione specifica tra CMYK, JPEG 2000 e il percorso di decodifica utilizzato.

I test svolti per isolare il problema

Le prove iniziali hanno incluso ricodifiche e conversioni, tra cui JPEG/DCT in CMYK e RGB, che consentivano di visualizzare le immagini. Sono verifiche utili per cercare alternative, ma cambiano più variabili e non bastano a individuare quale campo determini il comportamento.

Il confronto più controllato consiste invece nel mantenere identico il codestream JPEG 2000 e cambiare soltanto due byte della ftyp. Sulla coppia definitiva, usando PDFPage.thumbnail di PDFKit su macOS 26.6.2, build 25G83, abbiamo ottenuto:

BR="jpx ", CLi="jpx " + stesso codestream → PDFKit: pagina bianca

BR="jp2 ", CLi="jp2 " + stesso codestream → PDFKit: immagine visibile

Nei due container definitivi il box rreq (Reader Requirements) è assente in entrambe le varianti. La presenza o l’assenza di questo box non costituisce quindi una differenza tra GOOD e BAD. L’assenza di rreq è però rilevante quando si valuta la conformità JPX.

Il confronto byte per byte e le prove controllate permettono di associare il cambio di risultato alla ftyp in questi input. Non consentono, da soli, di ricostruire il percorso interno del decoder Apple.

Due PDF con due soli byte di differenza

La coppia definitiva è stata ridotta alle strutture necessarie per il test, rimuovendo i manifest C2PA e il commento del codestream. Il confronto riguarda i due PDF così ottenuti, ciascuno lungo 192.196 byte.

Entrambi:

  • hanno una sola pagina;
  • contengono una sola immagine;
  • misurano 192.196 byte ciascuno;
  • utilizzano /JPXDecode;
  • utilizzano DeviceCMYK;
  • contengono lo stesso codestream nel box jp2c;
  • hanno identica struttura PDF.

Nell’intero PDF cambiano soltanto i byte agli offset 506 e 514, contando da zero (rispettivamente 0x1FA e 0x202). Sono gli offset 22 e 30 dall’inizio dello stream JPEG 2000: il primo appartiene al brand principale, il secondo all’unica voce della compatibility list. La versione minore resta zero. Lo spazio finale nei brand seguenti è parte del valore.

Nella variante GOOD, che il PDFKit verificato visualizza:

brand principale (BR):       "jp2 "
versione minore (MinV):      0
unica compatibilità (CLi):   "jp2 "

Nella variante BAD, in cui il PDFKit verificato non visualizza l’immagine:

brand principale (BR):       "jpx "
versione minore (MinV):      0
unica compatibilità (CLi):   "jpx "

Dal punto di vista binario, in ciascuna delle due posizioni cambia solamente:

0x32  "2"

in:

0x78  "x"

La verifica è stata eseguita direttamente con PDFKit, tramite PDFPage.thumbnail, su macOS 26.6.2, build 25G83. Questo test dell’API va distinto dalle osservazioni effettuate nell’app Anteprima sul documento originario:

  • Variante JPX_BAD → PDFKit produce una pagina bianca.
  • Variante JP2_GOOD → PDFKit visualizza l’immagine.

Con Poppler 25.06.0, invece, entrambi i PDF definitivi mostrano l’immagine: i rendering prodotti a 512 pixel sono identici pixel per pixel. I risultati dei diversi visualizzatori vanno sempre riferiti alle versioni e ai file effettivamente provati.

La variante JPX_BAD non mostra l’immagine nel test PDFKit descritto e la trovate a questo link: JPX_BAD.

La variante JP2_GOOD mostra invece l’immagine nello stesso test ma con la codifica corretta e la trovate a questo link: JP2_GOOD.

Con questi due file non stiamo confrontando due immagini ricodificate diversamente: il codestream JPEG 2000 è identico tra GOOD e BAD, ma i due pdf hanno hash differenti, perché due byte sono diversi. L’espressione “stesso file, stesso hash” riguarda invece l’esperimento successivo, nel quale un unico PDF viene aperto con renderer differenti.

Le impronte SHA-256 della coppia definitiva senza metadati descrittivi sono riportate qui sotto. Consentono di verificare che i file scaricati coincidano con quelli analizzati: una successiva elaborazione o l’aggiunta di metadati può modificarli e far venir meno il confronto di due soli byte.

GOOD — 192196 byte
2270aedfdbc143090f40bb6f063d216de638757b06926e5fd07a236a162f03a2

BAD — 192196 byte
b1a52bdfac9bf5a705207f1a358b237b7eca5dd63c8cbedcd3c67adc29469cfb

Il test aggiuntivo: quale dei due byte cambia il risultato?

Abbiamo provato tutte e quattro le combinazioni del brand principale e dell’unica voce della compatibility list, modificando copie in memoria e lasciando invariati gli altri byte e nel controllo effettuato con PDFKit su macOS 26.6.2 il risultato è stato il seguente:

BR       CLi      MEDIUM          Cane-Gatto
"jp2 "   "jp2 "   immagine        gatto
"jpx "   "jp2 "   immagine        gatto
"jp2 "   "jpx "   pagina bianca   cane
"jpx "   "jpx "   pagina bianca   cane

In questi input, sul PDFKit verificato, cambiare il solo byte della compatibility list è sufficiente; cambiare soltanto il brand principale non produce la differenza. La coppia distribuita differisce per due byte, ma due byte non sono il minimo necessario a ottenere il cambio di visualizzazione nell’esperimento controllato. Le combinazioni intermedie sono varianti diagnostiche, non una certificazione di conformità dei container.

Quindi JPX è un errore e causa un baco?

JPX è un formato standard, definito dalla Part 2 di JPEG 2000. Il testcase non dimostra che JPX sia inadatto ai PDF o che il renderer Apple non possa mai visualizzarlo, né che vi sia un baco nel sistema di rendering PDF: dimostra una differenza di comportamento su una specifica coppia di input.

La specifica PDF, nella sezione dedicata a JPXDecode, prevede anche lo spazio colore enumerato 12, CMYK, occorre però distinguere questo requisito dalla conformità del container: nella variante marchiata jp2 , il box colr dichiara proprio EnumCS 12, mentre la specifica JP2 prevede per gli spazi enumerati i valori 16, 17 e 18.

Nella variante marchiata jpx manca inoltre il box rreq, richiesto dalla struttura JPX descritta nella specifica T.801: il solo cambio di brand non rende quindi il container automaticamente conforme a JP2 o JPX. Possiamo quindi parlare di una differenza di rendering riprodotta e questi file, da soli, non costituiscono una prova definitiva di violazione dello standard da parte di Apple.

La causa precisa nel software richiederebbe ulteriori verifiche, l’analisi dell’implementazione o un riscontro del produttore. Un confronto tra file pienamente conformi sarebbe inoltre necessario per separare i problemi di conformità degli input dalle diverse strategie con cui i renderer li gestiscono.

Un PDF di test per “riconoscere” il renderer

Lo stesso principio enunciat osopra può essere usato per costruire un PDF dimostrativo con due messaggi sovrapposti: il testo visibile dipende da come viene gestita l’immagine superiore, non da una vera identificazione del software.

Nelle prove descritte, il documento mostra “You are using Apple rendering” quando resta visibile l’immagine sottostante e “You are NOT using Apple rendering” quando viene dipinta quella superiore. Le scritte sono etichette dimostrative: non certificano quale motore o sistema operativo sia in uso.

Il meccanismo non richiede JavaScript, lettura dello User-Agent o riconoscimento del sistema operativo: sfrutta la diversa rappresentazione dell’oggetto JPEG 2000. Qualunque renderer con lo stesso comportamento potrebbe produrre lo stesso messaggio.

È una dimostrazione interessante di un principio più generale della document analysis: lo stesso insieme di byte può produrre rappresentazioni visive differenti a seconda dell’implementazione utilizzata per interpretarlo.

Le due versioni linguistiche del PDF dimostrativo sono disponibili qui di seguito, qui la versione italiana, mentre qui quella in inglese.

Come evitare il problema creando un PDF

Chi produce PDF destinati a una distribuzione ampia dovrebbe privilegiare strutture conformi e verificate con più renderer. Il formato va scelto in funzione dell’immagine, dello spazio colore, della qualità richiesta e delle applicazioni destinatarie.

Pur non trattandosi di un bug, se si mantiene JPEG 2000, bisogna generare un container conforme alle funzionalità e al colore effettivamente utilizzati: JP2 non si ottiene semplicemente rinominando il brand di un’immagine CMYK. Quando compatibile con le esigenze del documento, JPEG con /DCTDecode è un’alternativa da valutare e verificare.

La scelta deve distinguere codec, container e filtro PDF. Un’estensione del nome del file o il supporto dichiarato di un formato non sostituiscono la verifica del PDF finale.

In un workflow editoriale è opportuno verificare cosa accade dopo l’esportazione dal programma d’impaginazione, ad esempio provando ad aprire il pdf con diversi software e sistemi operativi: nel documento inizialmente esaminato, che ha dato il via alla presente ricerca, i metadati indicavano Adobe InDesign come Creator e un servizio successivo come Producer, campi che rappresentano indizi sulla lavorazione, non una prova sufficiente per attribuire la modifica delle immagini a uno specifico software.

Gli strumenti per l’analisi forense dei PDF e del rendering

Per una prima verifica è utile confrontare lo stesso documento con renderer indipendenti. Il fatto che Anteprima, o qualunque altro singolo visualizzatore, non mostri un’immagine non dimostra che i suoi dati siano assenti dal PDF.

Nel controllo della coppia definitiva abbiamo confrontato PDFKit e Poppler, mentre ullteriori applicazioni, come Acrobat o Foxit, possono ampliare la matrice di prova, purché si registrino versioni e risultati senza dedurli dal solo sistema operativo.

Per JPEG 2000, OpenJPEG offre strumenti per esaminare codestream e parametri di codifica. Ad esempio, la documentazione dei parametri del codestream distingue l’identificatore della trasformata 9/7 irreversibile da quello della 5/3 reversibile. Il successo di una decodifica non equivale però alla validazione completa del container.

Per il confronto binario occorre controllare sia gli stream estratti sia l’intero PDF. Anche i metadati e gli aggiornamenti incrementali possono introdurre differenze: nelle versioni precedenti della coppia, i manifest C2PA rendevano inesatta l’affermazione “due soli byte nell’intero file”.

Per l’analisi forense del pdf a basso livello, però, spesso la cosa più utile rimane esaminare direttamente:

/Image
/Filter /JPXDecode
/ColorSpace
/SMask

e quindi estrarre lo stream, distinguere i box presenti da quelli assenti e analizzarne i campi. Tra i box pertinenti rientrano:

jP
ftyp
rreq
jp2h
colr
jp2c

L’analisi informatica forense del PDF va completata con i marker del codestream, le risorse della pagina, l’ordine di disegno e gli eventuali gruppi di trasparenza. rreq, per esempio, è pertinente alla conformità JPX ma non è presente nella coppia definitiva.

Oltre il riquadro grigio: due immagini nello stesso PDF

Nel documento iniziale il sintomo era una fotografia non visualizzata, con un’area grigia al suo posto. Nel testcase a immagine singola, il risultato verificato tramite PDFKit è invece una pagina bianca. L’esperimento successivo rende la differenza ancora più evidente.

La differenza di rendering può essere sfruttata anche per ottenere un risultato molto più evidente, cioè fare in modo che lo stesso PDF mostri due immagini completamente diverse a seconda del renderer utilizzato.

Abbiamo realizzato un PDF contenente le fotografie di un cane e di un gatto. Sul campione analizzato abbiamo riprodotto questi risultati:

  • con PDFKit, tramite PDFPage.thumbnail, su macOS 26.6.2 compare il cane;
  • con Poppler 25.06.0 compare il gatto.

Il meccanismo consiste in due immagini sovrapposte con codifiche differenti. Nella struttura analizzata non ci sono JavaScript o istruzioni per selezionare il contenuto in base al viewer. I dati pertinenti all’esperimento sono:

Pagina:               700 x 700 punti
Image XObject:        2
Immagine sottostante: cane, JPEG /DCTDecode, RGB
Immagine superiore:   gatto, JPEG 2000 /JPXDecode, CMYK
Brand del gatto:      "jpx "
Ordine di disegno:    cane, poi gatto

Potete scaricare il “PDF di Schrödinger” dal seguente link: il nome “PDF di Schrodinger” è una metafora, perché entrambe le immagini sono già contemporaneamente nel file e il risultato dipende dal rendering, non da una modifica del documento durante l’apertura, il pdf quindi contiene un gatto e un cane contemporaneamente.

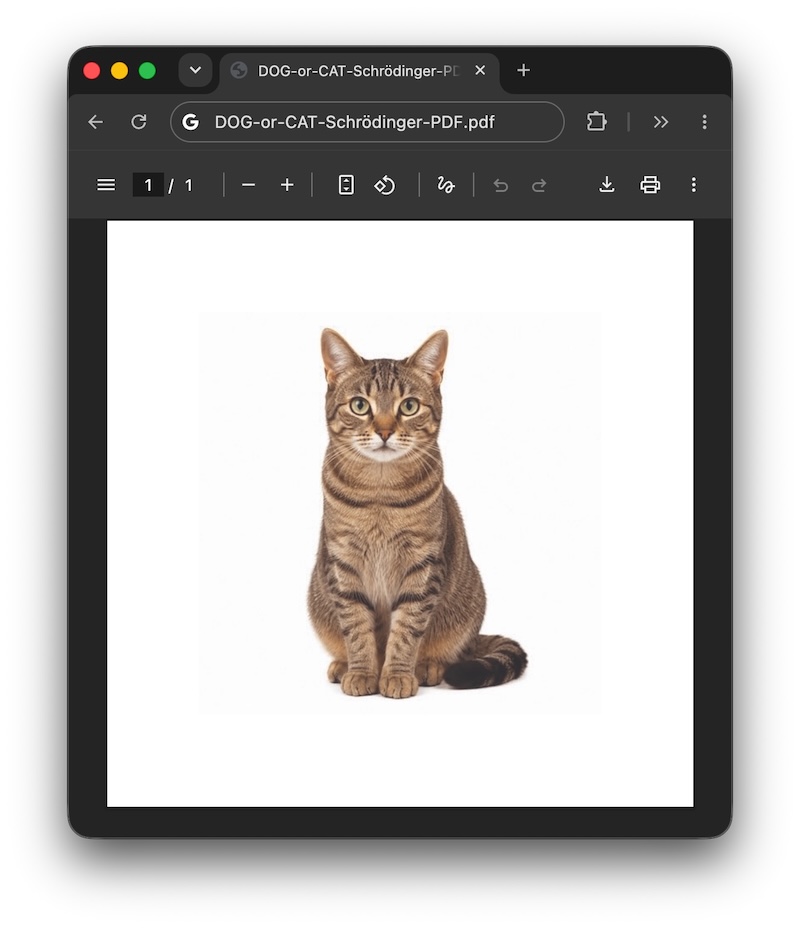
Le immagini seguenti documentano il confronto descritto tra Anteprima e Google Chrome su macOS. Il principio dell’esperimento è aprire lo stesso file con applicazioni differenti: l’identità dei file va verificata sui byte o tramite hash, non desunta dal solo nome mostrato nelle schermate.
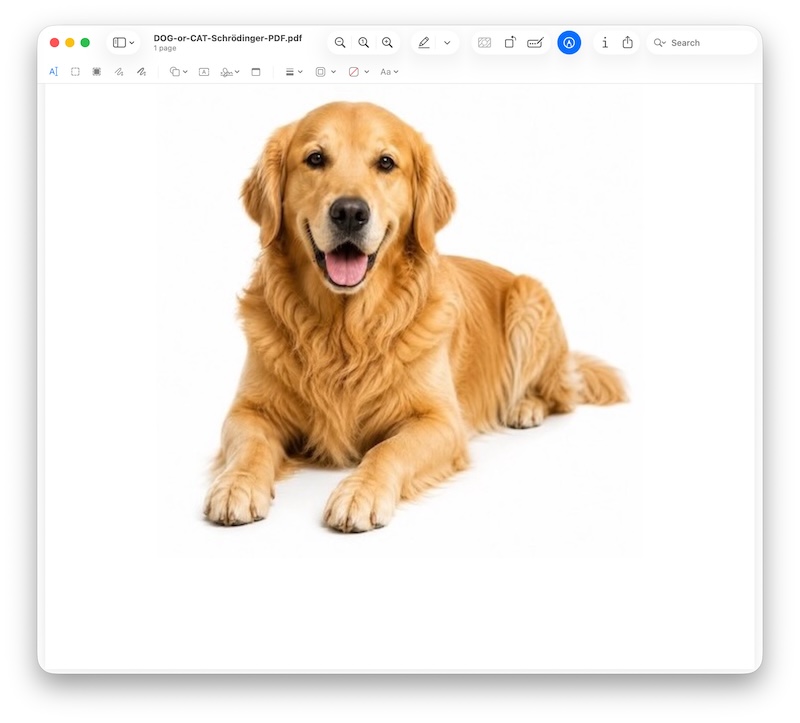
Il PDF di Schrödinger in Anteprima su macOS mostra il cane nella prova illustrata
Il PDF di Schrödinger in Anteprima su macOS: nella prova illustrata compare il cane.
Il PDF di Schrödinger in Google Chrome mostra il gatto nella prova illustrata
Il PDF di Schrödinger in Google Chrome su macOS: nella prova illustrata compare il gatto.

Il confronto fotografico comprende anche uno smartphone Android, a sinistra, e un iPhone, a destra: nelle applicazioni utilizzate per questa prova compaiono rispettivamente il gatto e il cane. La fotografia documenta il risultato visivo; da sola non dimostra l’identità binaria delle copie aperte né permette di generalizzare a tutte le applicazioni dei due sistemi.
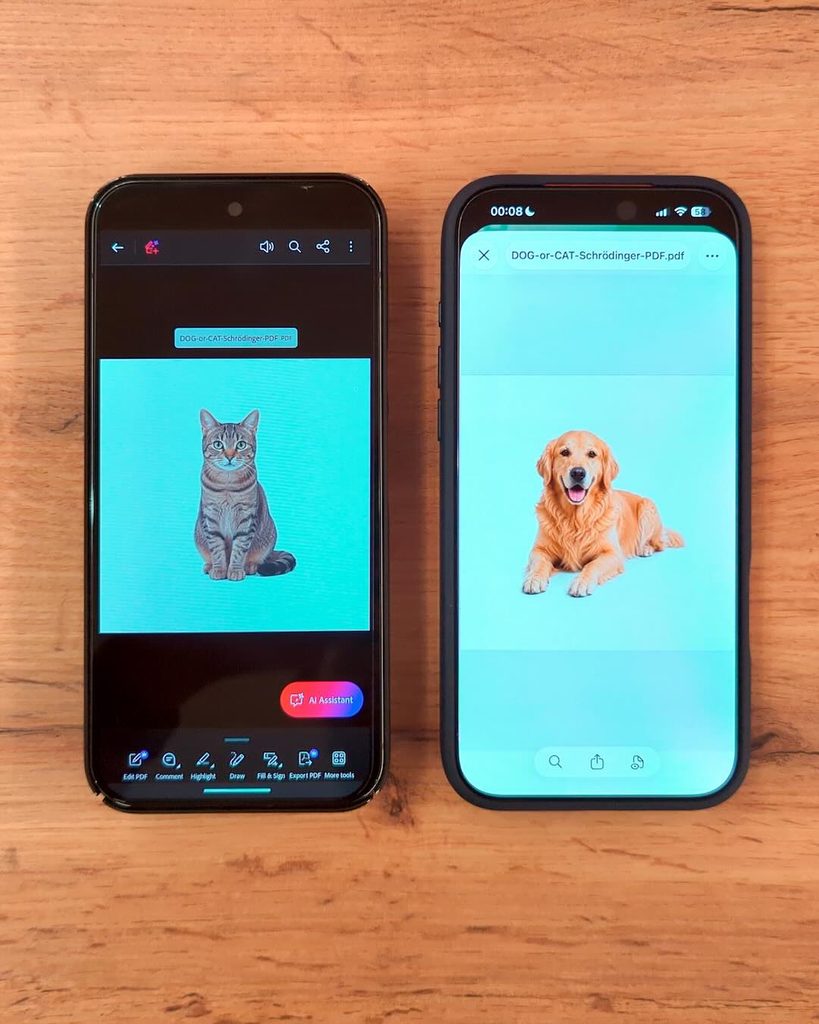
PDF di Schrödinger: gatto a sinistra su Android e cane a destra su iPhone, nelle applicazioni della prova

Questi esempi vanno letti come osservazioni sugli ambienti provati. Windows, Android e iOS sono sistemi operativi, non renderer: per riprodurre il risultato occorre specificare anche l’applicazione e la sua versione.

Come funziona l’esperimento

Il principio è quello già utilizzato nel PDF dimostrativo contenente i messaggi “You are using Apple rendering” e “You are NOT using Apple rendering”, ma applicato questa volta a contenuti fotografici.

Il documento contiene entrambe le immagini: il cane è un JPEG RGB con filtro /DCTDecode, mentre il gatto è un’immagine JPEG 2000 CMYK con filtro /JPXDecode e brand jpx . Un Form XObject, inserito in un gruppo di trasparenza isolato, disegna prima il cane e poi il gatto sulla stessa area. Quando il gatto viene dipinto, copre il cane; quando non viene dipinto, resta visibile il cane sottostante.

Il comportamento osservato si può quindi descrivere così:

  • Il gatto superiore non viene dipinto → resta visibile il CANE.
  • Il gatto superiore viene dipinto → copre il cane e compare il GATTO.

Il PDF non “decide” quale applicazione lo sta aprendo. Non contiene una condizione “se Apple mostra A, altrimenti mostra B”: il risultato dipende dall’esecuzione delle istruzioni di disegno da parte del renderer. I byte della ftyp riguardano il container del gatto; non trasformano il codestream di un animale in quello dell’altro.

Il problema non è più solo un’immagine che non si vede

Nel documento che ha originato la presente analisi la differenza della codifica poteva essere interpretata semplicemente come una fotografia non visualizzata. Il testcase Cane-Gatto rende invece evidente che l’omissione di un’immagine può anche lasciare visibile un contenuto alternativo già presente sotto di essa e quindi mostrare due immagini diverse con lo stesso PDF.

Il testcase con cane e gatto dimostra quindi un concetto più generale: una differenza nell’interpretazione o nel rendering degli oggetti di un PDF con stesso valore hash può determinare rappresentazioni visive sostanzialmente differenti dello stesso documento.

Due persone possono quindi aprire copie dello stesso file, verificarne l’hash e vedere contenuti differenti utilizzando software diversi. Questo è rilevante anche quando il documento viene esaminato prima di una firma: l’identità dei dati non garantisce l’identità di ciò che viene mostrato. Il testcase non costituisce però una prova del comportamento di uno specifico workflow di firma, che richiede verifiche separate.

Non è un sistema universale per riconoscere il viewer. Il risultato potrebbe cambiare con versioni differenti delle applicazioni o delle librerie, e lo stesso comportamento potrebbe essere condiviso da renderer diversi.

L’interesse nell’ambito informatico forense

Dal punto di vista della digital forensics, il confronto degli hash crittografici è uno strumento per verificare l’identità delle copie. Non è una verifica dell’equivalenza dei rendering: questa richiede osservazioni e confronti ulteriori.

In presenza di anomalie o contestazioni è utile documentare hash del file, sistema operativo, applicazione, versione, modalità di apertura e, quando noto, motore di rendering. È altrettanto utile conservare l’originale, distinguere le copie di lavoro e confrontare il risultato con un’implementazione indipendente.

Il cane e il gatto rendono visibile un limite pratico: l’esame del solo risultato a schermo non esaurisce l’analisi del documento.

Conclusioni

Da un documento editoriale con immagini non visualizzate siamo arrivati a una coppia controllata: una pagina, una sola immagine, stessa dimensione e due soli byte differenti nella ftyp, con codestream identico. Il PDFKit verificato mostra l’immagine nella variante GOOD e una pagina bianca nella variante BAD.

Poppler 25.06.0 produce invece lo stesso rendering per entrambe. Il test sulle quattro combinazioni dei campi ha mostrato inoltre che, nell’ambiente PDFKit verificato, basta il cambiamento del solo byte della compatibility list per modificare il risultato. Questo dettaglio restringe l’osservazione sperimentale, senza identificare da solo la causa nel software.

La differenza è riproducibile, ma i limiti di conformità dei container impediscono di presentare la coppia come prova definitiva di una violazione normativa di Apple. Per chi produce o analizza PDF, il criterio operativo è usare strutture conformi, conservare gli originali e verificare il documento finale con più renderer, senza trattare il cambio di brand come una riparazione universale.

In questa coppia, tra un PDF che mostra l’immagine e uno che sembra averla persa ci sono letteralmente due byte. Nel PDF Cane-Gatto non cambia neppure un byte tra un’apertura e l’altra: cambia il software che lo interpreta.
FTK Imager PRO: supporto alla cifratura e iOS

Dopo quasi 25 anni dall’uscita del preziosissimo – oltre che gratuito, anche per uso commerciale – software FTK Imager, la società Exterro (che ha acquisito AccessData) ha fatto uscire la versione “Pro” che ne contiene le stesse caratteristiche ma con il supporto alla decifratura e all’acquisizione logica di dispositivi iOS.

L’idea che si legge sulla pagina ufficiale di FTK Imager Pro su Exterro è quella di espandere le capacità già solide della versione gratuita con funzioni più sofisticate, soprattutto per trattare prove cifrate, dispositivi mobili e per ridurre i tempi nelle attività forensi. Secondo Exterro, FTK Imager Pro “permette di evitare l’imaging completo del disco e visualizzare file decrittati istantaneamente, preservando la catena di custodia e accelerando le indagini.”

Caratteristiche e prezzo di FTK Imager PRO

Nella pagina del “coming soon” del negozio Exterro, sono elencate le caratteristiche chiave previste per la versione Pro:

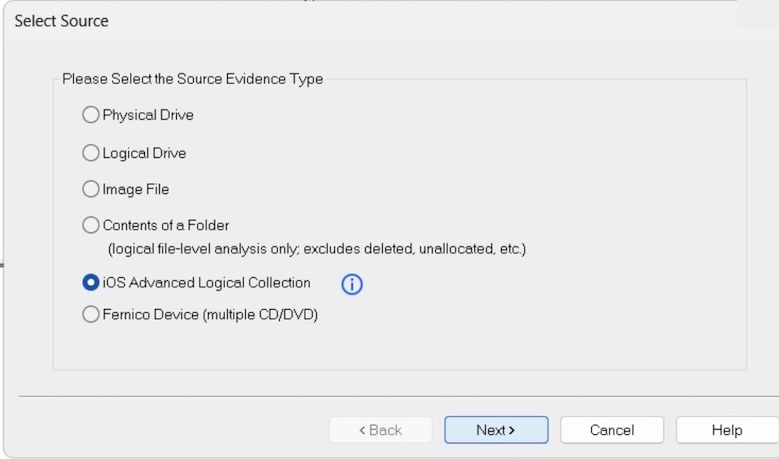
  • acquisizione logica avanzata “Advanced Logical” da Smartphone Apple iOS (messaggi, foto, dati app, registri chiamate);
  • rilevamento di immagini cifrate e richiesta delle credenziali per decrittarle;
  • accesso “live” a dati decrittati direttamente dal dispositivo, senza dover necessariamente creare prima un’immagine cifrata completa.

Il prezzo indicato sul sito del negozio è 499 USD all’anno per utente, la licenza è legata al PC sul quale viene installato il software.

La versione gratuita di FTK Imager: cosa offre

Per comprendere il salto rappresentato da FTK Imager Pro, è utile ricordare le funzioni offerte dalla versione gratuita di FTK Imager:

  • Creazione di copia forense di hard disk o supporti di memoria nei formati standard (E01, AFF, RAW, ecc.);
  • Creazione di copie forensi di cartelle o singoli file tramite contenitori forensi in formato A01;
  • Anteprima di file e directory contenuti nelle immagini o nei dispositivi collegati;
  • Esportazione tramite di file e cartelle selezionati da immagini forensi (es file di registro, eventi, etc…);
  • Calcolo e verifica degli hash (MD5, SHA1, SHA256) per garantire l’integrità dei dati acquisiti;
  • Montaggio di immagini forensi come unità virtuali per ispezione.

Queste funzionalità rendono la versione gratuita uno strumento molto utile e robusto per attività di copia forense di base, prendando ovviamente limitazioni quando si devono trattare dati cifrati, dispositivi mobili o situazioni in cui non si vuole acquisire l’intero disco indiscriminatamente.

Confronto: la versione gratuita di FTK Imager vs FTK Imager Pro

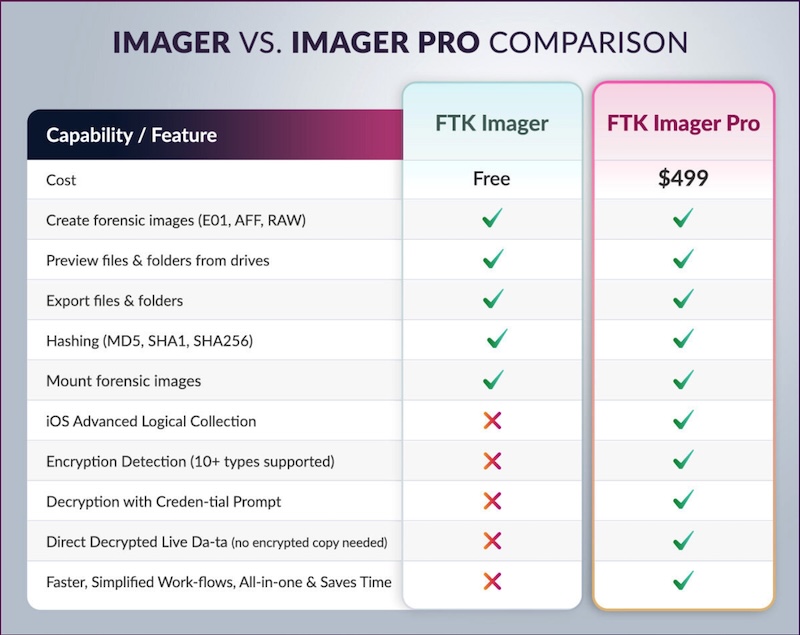
Sul sito ufficiale viene fornita una ottima tabella di confronto tra la versione gratuita di FTK Imager vs FTK Imager Pro:

Da questo confronto tra le due versioni – FTK Imager free edition e FTK Imager PRO a pagamento – emerge chiaramente che la Pro punta a colmare le lacune più critiche della versione gratuita, specialmente nelle aree dell’encryption, dell’analisi “live” e del supporto a dispositivi mobili.

Punti strategici e vantaggi principali di FTK Imager Pro

Emergono dai documenti evidenti vantaggi della versione a pagamento di FTK Imager PRO, tra i quali:

1. Trattamento delle evidenze cifrate / crittografia

Uno dei punti di forza più citati per FTK Imager Pro è la capacità di rilevare immagini cifrate (come BitLocker, FileVault, e altre) e richiedere le credenziali per decrittarle, permettendo di visualizzare i dati senza dover prima creare un’immagine cifrata completa. Questo è particolarmente utile, poiché oggi molte installazioni operative – persino sistemi Windows moderni – adottano cifratura di default, e dover acquisire un’intera copia forense cifrata per poi scoprire che l’oggetto d’interesse è piccolo può essere inefficiente.

2. Preview / accesso live ai dati decrittati

Invece di dover acquisire e poi analizzare per intero un disco, Pro consente l’accesso immediato ai file decrittati dal dispositivo, riducendo in modo drastico i tempi iniziali delle indagini (il cosiddetto “triage”). Questa funzionalità permette un flusso operativo più agile: si può decidere cosa acquisire in modo selettivo, anziché “prendere tutto”.

3. Supporto migliorato per dispositivi mobili (iOS)

FTK Imager Pro integra una modalità di copia forense logica avanzata per i dispositivi iOS: acquisizione forense di foto, messaggi, dati delle app, registri delle chiamate e così via, con un’interfaccia guidata.

FTK Imager Pro e l'acquisizione forense logica di iOS

Questo riduce la necessità di strumenti esterni di mobile forensics per l’acquisizione forense di iOS, consolidando in un’unica interfaccia maggior parte dei processi iniziali di raccolta di dati da smarthpone Apple iPhone con iOS.

FTK Imager Pro e Acquisizione Forense di iPhone con iOS

La iOS Advanced Logical Collection di FTK Imager Pro sembra simile a una Advanced Logical tipica degli strumenti tradizionali di mobile forensics, basata su backup iTunes come Cellebrite UFED, MSAB XRY, Oxygen Forensics, Magnet Axiom e simili.

4. Efficienza e riduzione dei tempi

Con le funzioni pro di decrittazione “on the fly” e l’accesso live, Exterro afferma che gli operatori possono “chiudere casi più rapidamente e con meno sforzo”. In scenari reali, dove il tempo è cruciale (incident response, indagini penali, contenziosi), questa efficacia può essere strategica.

5. Mantenimento della catena di custodia

Nonostante l’accesso diretto ai dati decrittati, l’obiettivo è preservare i principi forensi, tracciando gli accessi e controllando che qualsiasi modifica non comprometta l’integrità dell’evidenza. Exterro sostiene che Pro mantiene la catena di custodia anche nelle operazioni più snelle.

6. Unificazione delle funzionalità

FTK Imager Pro combina più funzioni (imaging, decrittazione, raccolta mobile) in un solo tool “leggero”, evitando di dover passare tra più strumenti o moduli. Questo può semplificare la formazione del personale e ridurre l’errore operativo.

Potenziali svantaggi e limiti da considerare

Il prodotto pare molto interessante ma ci sono alcune criticità o limiti ancora da valutare:

Costo / modello di licenza
Pro sarà offerto con un abbonamento annuale (499 USD per utente) il che rappresenta un investimento più che percorribile anche per piccole strutture ma la licenza è legata al singolo dispositivo (PC, Workstation) e non pare essere disponibile versione con licenza su dongle.

Dipendenza da credenziali valide
Le capacità di decrittazione “on demand” funzionano solo se si dispone delle credenziali corrette. In assenza delle chiavi, l’accesso live potrebbe non essere possibile, costringendo comunque ad acquisizioni complete o brute force nel caso in cui non si disponga delle password.

Complessità e rischi operativi
L’accesso “live” ai dati può esporre a rischi di alterazione accidentale o manipolazione: anche se il tool si propone di preservare integrità e catena di custodia, l’operatore deve essere cauta/o e ben addestrata/o.

Limitazioni nelle analisi più avanzate

FTK Imager (in versione gratuita o Pro) non è un tool di analisi forense completa che possa essere utilizzato come strumento principale per una perizia informatica, per esempio, non è pensato per compiere analisi complesse su file cancellati, recuperi approfonditi, correlazioni, reportistica forense sofisticata. Per queste funzioni, esiste il “FTK Forensic Toolkit” (la suite completa) che integra motori di analisi, ricerche full-text, database, e reportistica avanzata così come altre soluzioni di produttori concorrenti come Intella, Nuix, Magnet Axiom, Belkasoft, etc…

Stabilità / maturità del prodotto

Essendo un prodotto d’informatica forense “nuovo” (o comunque di recente rilascio), potrebbero emergere bug, limitazioni nelle versioni iniziali, o mancanze rispetto a casi limite non previsti. Occorre valutare affidabilità, aggiornamenti e supporto nel tempo, dato che non molto tempo fa era emerso un problema con una versione di FTK Imager gratuita rilasciata e subito ritirata dal web.

Compatibilità e dipendenze ambientali

Potrebbero esserci limitazioni legate ai sistemi operativi, alle versioni dei file system cifrati, a nuove forme di cifratura emergenti che non siano inizialmente supportate, a modelli iOS non previsti, ecc.

Conclusioni

Nel complesso, il software FTK Imager Pro sembra un ottimo prodotto per eseguire perizie informatiche forensi su supporti digitali come hard disk, pendrive e ora anche smartphone Apple iPhone con iOS: valuteremo di aggiornare l’articolo in base a test o feedback una volta che ve ne saranno.

Riuscirà la IA a sostituire gli Avvocati? I custom GPT in ambito legal.

“Riuscirà la IA a sostituire gli Avvocati?”. La domanda è provocatoria ma mentre cercavamo la risposta abbiamo scoperto i GPT personalizzati per/da avvocati, un fenomeno interessante e da approfondire.

Probabilmente no, così come per gli esperti di informatica forense di cui abbiamo parlato in altri articoli, ma abbiamo trovato diversi GPT personalizzati che in sostanza si presentano come “Assistenti Legali”, “Esperti di Diritto”, “Avvocato per Divorzio e Famiglia”, “Avvocato GPT”, “Avvocato Intelligente”, etc… programmati dagli utenti per fornire pareri legali gratuiti o supportare giuristi nella loro professione.

Ricordiamo che la differenza tra ChatGPT e un GPT personalizzato è che ChatGPT ha una base di dati enorme ma “generica”, può cercare online ma su risorse più o meno pubbliche, mentre un GPT personalizzato è programmato con istruzioni ma soprattutto documentazione specifica caricata da chi ha addestrato il sistema. Così un GPT civilista sarà programmato con istruzioni specifiche e avrà “in pancia” manuali e codici di diritto civile, esempi di ricorsi, decreti, memorie, atti di causa, etc… che possono aiutare altri avvocati civilisti e relativi studi legali a predisporre le loro, oltre che utenti finali ad avere pareri legali gratis.

Abbiamo testato alcuni Custom GPT in ambito legal, creati da avvocati per avvocati o anche per l’utente finale, verificando da chi sono stati programmati, con cosa sono stati addestrati e come si comportano rispetto a un generico ChatGPT: ve ne riportiamo cinque ma sappiate che l’avvocato digitale è uno dei GPT più presenti, ne abbiamo contate svariate decine solo in italiano, mentre ad esempio per la digital forensics di GPT custom italiano ce n’era uno solo.

1) https://chatgpt.com/g/g-y7PAcCcdL-avvocato-gpt-divorzio-e-famiglia (GPT addestrato in ambito di divorzio e famiglia)

2) https://chatgpt.com/g/g-QmqHyKVuj-avvocato-italiano-gratis-gpt (Assistente virtuale specializzato in consulenza legale preliminare nei settori del diritto penale, civile, divorzio, abitazioni, tributario e costituzionalista)

3) https://chatgpt.com/g/g-9QkahSGdd-esperto-di-diritto-tributario-italiano (GPT che offre risposte su normative fiscali italiane, dichiarazioni e imposte, riforme fiscali, interpretazione di giurisprudenza e supporto fiscale)

4) https://chatgpt.com/g/g-kW4AcNvuL-martelletto-avvocato-intelligente (Assistente Legale Personale)

5) https://chatgpt.com/g/g-hkeYAe7aT-avvocato-gpt-contratti-e-leggi-commerciali (Avvocato Digitale esperto in contrattualistica e diritto del commercio)

Valgono sempre i caveat del non fidarsi troppo di ciò che si ottiene da questi sistemi: anche se sono certamente più precisi di un generico GPT il parere legale gratuito ottenuto non è da considerarsi attendibile se non vagliato da un professionista, anche perché si rischia di finire come a Firenze dove un avvocato ha citato negli atti sentenze inesistenti ricavate da AI con ChatGPT e si è sfiorato il rischio di responsabilità aggravata per lite temeraria.

Stesso dicasi, come già accennato, per i custom GPT in ambito informatica forense e digital forensics: possono fornire una guida, ma attenzione a cosa si carica e cosa si ottiene.

Non è finita qui, nei prossimi articoli illustreremo:

1) Come creare un GPT custom in ambito legal o digital forensics;

2) I due principali modi di trovare GPT custom fatti da altri, anche quelli che magari non era intenzione rendere pubblici;

3) Quali sono i rischi non tanto per chi usa i GPT custom quanto per chi li programma e addestra.

Stay tuned! 🙂

Recupero di messaggi WhatsApp eliminati tramite Msgstore Increment

Recentemente, durante l’analisi di uno smartphone Android, è stato necessario recuperare dei messaggi cancellati appartenenti ad una chat eliminata dall’applicazione di WhatsApp. Fino a poco tempo fa anche effettuando un’analisi tramite software professionali quali Cellebrite UFED, Oxygen Forensic Detective e Magnet Axiom, non era possibile recuperare tale chat poiché eliminata prima del suo inserimento all’interno del classico backup periodico locale del database “msgstore.db” e quindi non visibile con le metodologie standard di recupero dati.

Di recente la funzionalità di recupero delle chat non presenti nei backup periodici è stata aggiunta ai software di mobile forensics, ma riteniamo utile illustrare in dettaglio come era possibile anche prima dell’aggiunta – e lo è tuttora – procedere manualmente con l’ispezione dei file relativi all’applicazione di WhatsApp e recuperare chat cancellate.

Nello specifico, illustreremo come recuperare una porzione della chat – non presenti nel DB o nei backup tradizionali – grazie all’analisi di un altro file di backup, incrementale e non completo: il “msgstore-increment.db“.

Cos’è il msgstore-increment.db e a cosa serve?

L’applicazione di WhatsApp, quando installata su dispositivi Android, effettua dei backup periodici del database principale “msgstore.db”, contenente tutte le informazioni correlate all’account di WhatsApp, inclusi i messaggi.

Purtroppo, la creazione dei backup e la loro gestione, in alcuni casi, può risultare difficoltosa da parte dell’applicazione soprattutto in situazione in cui i dati gestiti risultano essere centinaia di MB se non GB. Per questo motivo, per minimizzare la perdita dei dati e ottimizzare la gestione della memoria sul dispositivo, WhatsApp esegue dei backup incrementali, tra ogni backup completo, dentro i quali vengono salvati solo i cambiamenti avvenuti nell’applicazione: ad esempio, se il giorno successivo al backup completo vengono inviati cento messaggi, essi vengono inclusi all’interno del backup incrementale eseguito per quel giorno.

Questo significa che, se in seguito alla creazione del backup completo vengono inviati cento messaggi e poi cancellati, essi possono essere recuperati dal backup incrementale, ammesso che non siano stati eliminati prima della sua creazione.

A oggi, software professionali come Cellebrite UFED o Oxygen Forensics supportano il parsing del backup incrementale msgstore-increment, ma fino a pochi mesi fa era una funzionalità probabilmente ancora in lavorazione, dato che è comparsa di recente. Di conseguenza, per tentare il recupero dei messaggi eliminati, in passato, è stato necessario comprendere le logiche alla base di questo tipo di dato e creare uno script in grado di automatizzare l’estrazione di eventuali messaggi cancellati, ma ancora presenti nell’increment, mentre oggi chi ha a disposizione software professionali può eseguire il recupero direttamente tramite le funzionalità interne.

Come funziona e come si estraggono i dati dall’archivio msgstore-increment.db?

Il primo passo è stato quello di approfondire il funzionamento del backup incrementale, avendo prima replicato uno scenario in cui questa funzionalità ha generato degli increment. Tramite l’analisi dei dati generati dall’applicazione WhatsApp, sono stati individuati e analizzati diversi file denominati “msgstore-increment.db.crypt14”, ovvero archivi compressi e cifrati. Tali archivi sono stati decifrati attraverso l’utilizzo dello strumento “wa-crypt-tools” (https://github.com/ElDavoo/wa-crypt-tools) e, successivamente, decompressi, ottenendo file strutturati in formato JSON e un file binario denominato “messages.bin”.

archivio-decifrato-increment

Contenuto dell’archivio msgstore-increment.db.crypt14, backup incrementale

Tra i file in JSON ne è presente uno chiamato “header.json” dentro il quale sono contenute informazioni utili, relative agli altri file presenti nella cartella, compreso “messages.bin”. Inoltre, dall’analisi effettuata sul file binario, è stato possibile determinare il formato utilizzato per la codifica dei dati, ovvero il protocollo protobuf.

Protobuf è un formato di serializzazione dati sviluppato da Google e viene spesso utilizzato nella trasmissione delle informazioni tra applicazioni o per la memorizzazione di dati in un formato binario poiché risulta essere più leggero e performante rispetto a JSON o XML.

Il funzionamento è relativamente semplice, è necessario definire la struttura dei dati tramite la creazione di un file “.proto” e utilizzare un compilatore per la creazione di uno script in grado di codificare i dati basandosi, appunto, sul protocollo definito. Di seguito un esempio di definizione del protocollo:

Esempio di definizione per protobuf

Esempio di definizione per protobuf

In questo caso, uno script basato su tale definizione sarà in grado di creare un file binario contenente i dati “nome” ed “eta” riportati nel file protobuf.

Nell’applicazione di WhatsApp avviene la stessa cosa: il file binario “messages.bin” viene creato da una porzione di codice contenuta nell’applicazione ed è basato su un file “proto” dentro la quale è definita la struttura dei messaggi e delle conversazioni.

Inoltre, il file binario “messages.bin” viene strutturato con una o più porzioni del dato binario codificato con protobuf, tali porzioni vengono definiti anche segmenti o “length-delimited” (https://protobuf.dev/programming-guides/encoding/#length-types). Pertanto, per leggere il contenuto del file è prima necessario separare i vari segmenti e successivamente procedere con la lettura.

Rappresentazione dei segmenti contenuti nel file messages.bin

Rappresentazione dei segmenti contenuti nel file messages.bin

Per la separazione di ogni singolo segmento presente nel file “messages.bin” abbiamo creato uno script in python, che mettiamo a disposizione sulla nostra repository GitHub (https://github.com/Forenser-lab/wa-increment-decoder/blob/main/splitter.py), in grado di leggere il file “messages.bin” e creare diversi file binari ognuno contenente il dato (segmento) protobuf da leggere.

Successivamente, per la lettura di ogni singolo file, abbiamo utilizzato il tool “protobuf inspector” (https://github.com/mildsunrise/protobuf-inspector), uno script in grado di leggere un file binario codificato con protobuf:

Output del tool protobuf_inspector

Output del tool protobuf_inspector

Nonostante sia stato possibile estrapolare i vari messaggi contenuti nei segmenti, essi sono risultati un’aggregazione di dati “anonimi”. Sebbene alcuni dei dati ottenuti dall’estrazione della chat contengano campi con un significato intuitivo, come il testo del messaggio o il timestamp, altri sono risultati ignoti rendendo di conseguenza difficoltoso stabilirne il significato reale. Questo accade poiché noi non siamo in possesso della definizione del protocollo “proto” utilizzato da Meta e in grado di leggere correttamente i dati contenuti nel file binario.

Ciononostante, in rete, sono presenti diversi progetti di reverse engineering aventi oggetto la definizione del protocollo impiegato su WhatsApp, incluso quello del repository GitHub Wa-Proto (https://github.com/wppconnect-team/wa-proto) effettuato sulla versione web del software. Successivamente, provando ad adattare la loro definizione per il nostro scopo, siamo riusciti a decodificare correttamente l’intero contenuto del file binario “messages.bin” ottenendo tutti i dati in chiaro con il loro relativo significato.

A questo punto, è stato semplice creare uno script in grado di generare un file CSV contenente tutti i messaggi presenti nel file binario, indicando il caso in cui un messaggio risultasse essere stato eliminato. Si noti che sono stati effettuati alcuni test che hanno considerato anche i media (immagini, video, etc.) e in alcuni casi nella cartella decifrata e decompressa relativa all’increment è presente il folder “messages.bin” contenente miniature di immagini eliminate (successivi aggiornamenti saranno orientati a verificare in che misura è possibile recupera media o tracce di essi).

Proof of Concept di decifratura e analisi del msgstore-increment.db

Innanzitutto, è stato riprodotto lo scenario: abbiamo inizializzato una nuova chat, utilizzandola per qualche giorno per poi infine eliminarla, evitando che fosse memorizzata nel backup “msgstore.db”. Grazie a questa riproduzione, sebbene i messaggi della chat non siano stati inclusi nel backup settimanale, sono comunque stati inseriti nel backup incrementale giornaliero.

Nell’immagine seguente viene riportata un’illustrazione dello scenario riprodotto. Nello specifico è possibile vedere come il backup principale venga creato alle ore 02:00 AM del 10/01, successivamente alle ore 01:35 PM dello stesso giorno viene creata una conversazione con ID 123 che sarà inclusa nel backup incrementale alle ore 02:00 AM del 11/01. Infine, alle ore 04:00 PM del giorno 11/01 la chat con ID 123, viene eliminata (ma risulta ancora presente nel backup incrementale creato precedentemente):

Timeline dello scenario di riferimento

Timeline dello scenario di riferimento

Successivamente, sono stati estratti i backup incrementali dal dispositivo Android, solitamente contenuti nella directory “/data/media/0/Android/media/com.whatsapp/WhatsApp/Databases/” e opportunamente decriptati tramite l’apposita chiave di cifratura, ottenendo così i seguenti file:

  • msgstore-increment-1-2025-01-16.1.db;
  • msgstore-increment-2-2025-01-16.1.db;
  • msgstore-increment-3-2025-01-16.1.db;
  • msgstore-increment-4-2025-01-16.1.db.

I vari backup sono stati inseriti tutti all’interno della stessa cartella e in seguito è stato eseguito lo script da noi creato per il recupero dei messaggi, il quale ha generato un file CSV contenente la lista di tutti i messaggi estratti:

Generazione del file CSV contenente i messaggi recuperati

Generazione del file CSV contenente i messaggi recuperati

Conclusioni

Grazie ad un approfondimento sulla gestione dei backup nell’applicazione di WhatsApp per dispositivi Android, siamo riusciti a comprendere come essi vengono strutturati tramite il concetto di backup incrementali. L’analisi ci ha portato alla creazione di un piccolo tool, scritto in python, in grado di estrarre in modo strutturato i messaggi dal backup incrementale “msgstore-increment.db” in modo efficiente, con dettagli di rilievo come il timestamp e senza bisogno di utilizzare altri strumenti.

La funzionalità dei backup incrementali permette il recupero di messaggi eliminati tra la creazione di un backup integrale, locale, “msgstore.db.crypt14” e un altro, quindi non recuperabili tramte le tradizionali tecniche di analisi forense e undelete dal DB sqlite o dai backup.

Per chi volesse sperimentare o provare l’estrazione di questi messaggi, lasciamo qui di seguito il link dello script scaricabile dalla nostra repository GitHub (https://github.com/Forenser-lab/wa-increment-decoder).

GPT personalizzati su informatica forense e digital forensics

Per chi fosse nteressato all’uso della IA in ambito informatica forense, segnaliamo tre GPT personalizzati e custom creati da utenti esterni su ChatGPT utilizzabili da chiunque, configurati per fornire supporto su argomenti che riguardano la digital forensics e la perizia informatica.

GPT custom per digital forensics

Nei repository pubblici di GPT sono presenti decine di custom GPT in tema digital forensics, non conosciamo gli sviluppatori e quindi non possiamo garantire sulla qualità, considerato però che la parte iniziale del dialogo con l’IA può essere proprio orientata a capire su che basi sono stati configurati i bot, con quali documenti, tramite quali indicazioni operative, limiti e vincoli, così da valutare l’ambito di applicazione di ogni GPT.

1) https://chatgpt.com/g/g-g4xE4lNk0-digital-forensics-ita

GPT italiano che rappresenta – tramite l’intelligenza artificiale – un esperto digitale in Informatica Forense che applica normativa italiana in Mobile, Computer, Cloud e Network Forensics e con specializzazione su:

✔ Acquisizione e analisi forense di dati da computer, dispositivi mobili, reti e cloud.
✔ Identificazione di violazioni di dati e analisi di eventuali compromissioni.
✔ Utilizzo di strumenti forensi (come EnCase, FTK, Cellebrite, Autopsy) e tecniche di scripting per analisi avanzate.
✔ Supporto legale e conformità alla normativa italiana sulla digital forensics.
✔ Redazione di report forensi validi in tribunale.

2) https://chatgpt.com/g/g-H1VZzHBSK-digital-forensics-advanced-specialist

GPT custom in inglese personalizzato sulla Digital Forensics, progettato su ChatGPT per supportare chi esegue perizie informatiche tramite intelligenza artificiale esperti nell’analisi forense di dispositivi digitali, tra cui smartphone, tablet, droni e altri dispositivi elettronici. È basato su una vasta raccolta di manuali e guide forensi, coprendo strumenti come Cellebrite Physical Analyzer, Oxygen Forensic Suite, Magnet AXIOM, Exterro FTK, e altri, specializzato su:

✔ Estrazione e analisi dei dati da dispositivi mobili, computer e droni.
✔ Recupero dati e prove digitali, incluse cronologie di navigazione, dati eliminati e registri di sistema.
✔ Utilizzo di strumenti forensi per acquisizione e analisi, con procedure e best practice.
✔ Principi di sicurezza e gestione delle prove digitali, fondamentali per garantire l’integrità e l’ammissibilità delle prove.

3) https://chatgpt.com/g/g-66mvwhTqv-dfir-digital-forensics-and-incident-response

Custom GPT specializzato in supporto alla perizia informatica mediante AI personalizzato su Digital Forensics e Incident Response (DFIR), ovvero l’analisi forense digitale e la risposta agli incidenti di sicurezza informatica, in particolare utile per:

✔ Analisi forense digitale – Raccolta ed esame di prove digitali da dispositivi come computer, smartphone e reti.
✔ Risposta agli incidenti – Strategie per identificare, contenere e mitigare minacce informatiche come malware, attacchi ransomware o data breach.
✔ Recupero di dati e tracce digitali – Tecniche per estrarre informazioni da hard disk, memorie volatili, file cancellati e log di sistema.
✔ Threat hunting e analisi malware – Identificazione di comportamenti sospetti e analisi di codice dannoso.
✔ Best practice di sicurezza – Consigli su come proteggere sistemi e dati da attacchi informatici.

Ci sono decine di GPT negli archivi ChatGPT sull’argomento informatica forense e perizie informatiche che possono fornire supporto agli analisti grazie all’intelligenza artificiale: ne abbiamo segnalati tre tra quelli con maggiori feedback e consigliamo ovviamente di non caricare documenti riservati né fidarsi ciecamente di ciò che produce l’AI ma può talvolta essere utile – quantomeno dal punto di vista tecnico e giuridico – per trovare suggerimenti, idee o spunti.

Exterro, dietro front per FTK Imager

Nell’articolo pubblicato il 28 ottobre scorso sul nostro sito, avevamo segnalato un importante aggiornamento dell’applicazione FTK Imager, uno degli strumenti più utilizzati del panorama informatico forense.

La novità determinante introdotta con la nuova versione 4.7.3.61 (“Exterro_FTK_Imager_4.7.3.61.exe” con hash MD5 “fb98287965d4e3b9a7e9de50a781dca4”, SHA1 0ff6f6ee8fb640a3de1c5195e764c67df7e6e996, SHA256 f4f56139a6c667dba6f6c09b7dd7c8bc72cbbe6ec8de0a82bb5a49676b6b5ee0) dell’applicazione era la possibilità di gestire la crittografia BitLocker che nel tool si mostrava pienamente supportata nei processi di mounting dell’immagine cifrata (senza necessità di montare il volume logico), anche nel caso di presenza di “clear key” e generazione di copia forense già decifrata.

Nei giorni immediatamente successivi la società ha rimosso il link dalla pagina di download, generando non poco stupore (e anche un pizzico di preoccupazione visto che nel changelog erano presenti fix di vulnerabilità) tra gli utenti:

ftk-imager-unavaiable

Successivamente, il 3 novembre, Exterro ha rilasciato su X, dal suo profilo, un comunicato dove spiegava che il rilascio della versione che gestisce BitLocker non è stato sostanzialmente intenzionale, non precisando se la successiva versione dello strumento che sarebbe stata rilasciata il 5 novembre avrebbe incluso ancora tale funzionalità:

exterro-post-X

Tra il 5 e il 6 novembre Exterro ha annunciato sul suo portale, nella sezione relativa al download di FTK Imager (sbagliando nella sua precisazione ad indicare il numero di versione sostituita, riportando “4.7.3.21” anziché “4.7.3.61”) la pubblicazione della versione 4.7.3.81 (hash MD5 “3815b9c2a6aa8898ecbe55353aaf4b79”, SHA1: “5ae3e1ea937f56367409deebb4b71147a6b883f4”, SHA256 “443843a3923a55d479d6ebb339dfbec12b5c1aabed196bf0541669abbe9b1c51”) che non include la funzionalità di gestione della crittografia:

comunicato-exterro-rilascio-non-intenzionale

Mentre questo “passo indietro” ha oggettivamente scosso la comunità di tecnici che ogni giorno utilizzano lo strumento e si sentivano arricchiti dall’introduzione di una feature così vantaggiosa, ci si chiede se mai si vedrà una nuova pubblicazione dello strumento con inclusa questa funzionalità. È sempre più facile, infatti, imbattersi in dischi che sono crittografati con Bitlocker e possedere un tool che supporti la decifratura/mounting delle immagini cifrate è strategico sia nella fase di produzione di copia forense che di processing e analisi dei dati.

Nel frattempo, si tornerà all’utilizzo di soluzioni alternative come ad esempio Arsenal Image Mounter che già nella versione gratuita include la possibilità di montare immagini forensi di volumi crittografati con BitLocker che utilizzano la “clear key” e agevola il processo di generazione di copia decifrata.

Non è chiaro quale sia il motivo esatto del “dietro front” di Exterro, anche se è facile immaginare che la società possa voler includere tale funzione in una versione più esclusiva (magari a pagamento) dell’applicazione o all’interno della suite di analisi FTK (Forensic Toolkit). Resta anche l’ipotesi che la società voglia mantenere le feature della versione 4.7.3.61 in una “internal build” che non verrà rilasciata al pubblico.

FTK Imager: novità dell’aggiornamento in download gratuito

È recente la pubblicazione della nuova versione del tool della società Exterro “FTK Imager”, il “coltellino svizzero” dell’informatica forense che ogni consulente informatico forense ha nel proprio repertorio e utilizza quasi quotidianamente per fare copie forensi, aprire e lavorare su immagini forensi, acquisire la RAM dei PC, estrarre file di sistema, virtualizzare o fare analisi forensi su SSD, HD e supporti di memoria.

Il download della nuova versione è disponibile al link del sito di Exterro https://www.exterro.com/ftk-product-downloads/ftk-imager-4-7-3-61 e introduce funzionalità attese e interessanti. Ricordiamo che il download di FTK Imager e gratuito e può essere effettuato allo stesso link presente nella sezione “Product Downloads”:

download-FTK-Imager

Le novità dell’aggiornamento

Il changelog fornito dalla società è piuttosto scarno ed indica come unica novità il miglioramento nel processo di “mounting” delle immagini di Windows 11. Il resto dei cambiamenti interni riguarderebbe la risoluzione di bug:

Changelog-aggiornamento-FTK-Imager

Installando e avviando lo strumento si possono apprezzare novità molto più interessanti; infatti, è ora possibile montare e navigare immagini forensi di drive che sono crittografati con BitLocker e si possono, con questo aggiornamento, creare ed esportare copie forensi di dischi cifrati in formato non cifrato.

Tale mancanza, in questi anni, è stata sopperita dall’utilizzo di strumenti esterni, come Arsenal Image Mounter, strumento in grado di montare immagini forensi di dischi cifrati con BitLocker, riconoscere la presenza di “clear key”, generare immagini decifrate, etc.

Riconoscimento, mounting e acquisizione di volumi crittografati

Vediamo ora come si concretizzano le novità più importanti, avviando direttamente lo strumento.

Adesso, selezionando “Add evidence Item” o “Create disk Image” e indicando un volume fisico cifrato con BitLocker, abbiamo accesso ad una nuova schermata, che propone l’inserimento della chiave a 48 bit o della password (nel caso di drive esterni):

creazione-immagine-forense-disco-cifrato

Cliccando poi su “OK” si ha accesso al volume fisico come se fosse decifrato.

Come accennato, attraverso questa nuova funzionalità è possibile produrre copia forense del disco crittografato, direttamente in forma decifrata. In questo caso lo strumento avvisa l’utente del fatto che il valore di hash della copia forense del drive in forma decifrata differirà dal valore di hash che si otterrebbe acquisendolo nella sua forma crittografata:

conferma-creazione-immagine-cifrata

Premendo su “Cancel” anziché su “OK” si procederebbe con l’acquisizione forense del disco nella sua forma cifrata:

creazione-immagine-forense-disco-cifrato-cancel
creazione-immagine-forense-disco-cifrato-sì

In questo caso sarà comunque possibile montare, sempre con FTK Imager, la copia così ottenuta e creare a posteriori la relativa immagine decifrata. Un’ulteriore possibilità sarà montare il drive decifrato sia fisicamente che logicamente, per mezzo dell’opzione “Image Mounting…”:

mounting-immagine-cifrata

La versione “portable” standalone

FTK Imager viene distribuito come versione installabile, ma può agevolemente essere convertito in versione portabile o standalone (un tempo persino distribuita da Accessdata come “FTK Imager Lite“) avviando l’installer e copiando su di una pendrive la cartella dove il programma viene installato.

Versione-portable-FTK-Imager

Le librerie DLL necessarie per la sua esecuzione saranno contenute all’interno della cartella “C:\Program Files\AccessData” e sono sufficienti per far girare il tool FTK Imager in modalità portable anche su altri PC senza installarlo, ma avviandolo direttamente da una pendrive o da una risorsa di rete. A questo punto, si otterrà una versione FTK Imager Portable, da utilizzare sul campo, così da evitare di sporcare il sistema con una nuova installazione.

Conclusioni

La nuova funzionalità di mounting di drive e immagini forensi di dischi cifrati con BitLocker nonché la possibilità di creare immagini di drive in formato già decifrato, accontenta i molti utenti che quotidianamente utilizzano FTK Imager per le attività di acquisizione e analisi forense ed altre attività a supporto della perizia informatica.

Sempre consigliabile creare subito una versione FTK Imager Portable o FTK Imager Lite, così da poter utilizzare il software senza necessità d’installarlo, ma salvandolo ad esempio su di una pendrive USB ed eseguendolo direttamente da lì, sporcando il meno possibile il sistema in fase di analisi o copia forense.

In passato, queste lacune potevano essere colmate mediante l’ausilio di altri strumenti gratuiti, ed ora anche FTK Imager può vantare nel suo già ricco armamentario queste funzionalità, senz’altro molto utili per qualunque Digital Forensics Expert.

Disponibile per il download Tsurugi Linux 2024.1 live distro gratuita e open source per informatica forense

Il 30 luglio 2024 è stata rilasciata la nuova versione della live distro di informatica forense “Tsurugi” nella versione lab 2024.1, disponibile per il download gratuito sia come immagine di 16.7 GB, sia come macchina virtuale da 33.7 GB. Questo strumento, essenziale per i professionisti dell’informatica forense, è tra i più utilizzati nel campo del digital forensics, insieme alla celebre distribuzione Caine Linux.

Tsurugi Linux è una distribuzione Linux open source progettata per l’informatica forense, la risposta agli incidenti e l’analisi di malware, che offre una soluzione potente e versatile tramite tool e strumenti software di altissima qualità. Questa distro è specificamente ideata per supportare le indagini digitali, mettendo a disposizione una vasta gamma di strumenti preinstallati che rispondono alle diverse esigenze dei consulenti forensi, come l’acquisizione dei dati, le attività di copia forense, l’analisi della memoria e l’analisi del traffico di rete. Una delle sue caratteristiche principali è la possibilità di funzionare in modalità live, permettendo agli investigatori di operare senza modificare lo stato del sistema esaminato, garantendo così l’integrità delle prove raccolte.

La live distro opens source Tsurugi Linux è altamente configurabile, con moduli specifici per diverse esigenze forensi, come l’analisi di sistemi Windows, dispositivi mobili o indagini su malware, attività frequenti durante la realizzazione di perizie informatiche. Si distingue anche nell’analisi della rete e della memoria, offrendo strumenti avanzati per l’acquisizione forense e l’analisi di traffico di rete e memoria volatile, elementi cruciali nelle indagini forensi moderne.

Essendo un software open source, Tsurugi rappresenta una scelta eccellente per gli investigatori digitali, grazie alla sua struttura modulare che permette di creare un ambiente di analisi mirato e ottimizzato per ogni tipo di indagine digitale.

Con una solida community, una documentazione dettagliata e la compatibilità con numerosi altri strumenti forensi, Tsurugi Linux è una risorsa imprescindibile per i professionisti del settore che necessitano di una piattaforma affidabile e sicura per le loro indagini.

La distro Tsurugi può essere scaricata gratuitamente dalla pagina ufficiale dei download del sito Tsurugi-Linux. Il software è offerto senza alcuna garanzia, secondo i termini della licenza General Public License (GNU).

È importante verificare sempre i valori hash delle ISO o della VM scaricata dal sito Tsurugi, utilizzando la firma digitale prodotta dagli sviluppatori e distribuita sul sito. Per comodità, riportiamo i valori hash SHA512 delle due release di Tsurugi Linux Lab 2024.1:

tsurugi_linux_2024.1.iso: 885aa818a6b61803b74ffd885a66d676e6ae6279cafe9ff53cc9ba15aabebb844c4428a2b6480061a82dc466edb2728811e0a03252aaf0aa5e8b158690a1c678

tsurugi_linux_2024.1_vm.ova: 30d88f3a683862642ee8f1c13f43044f13e62471b65ed7e63ed459485ad5259f42c242a5df0ff179f6a80750f4055c33ad5f310277ed8d38b4e9da8d0db85a13

La nuova versione di Tsurugi Linux, rispetto a quella rilasciata il 22 dicembre 2023, include le seguenti novità, elencate nel changelog ufficiale:

  • Kernel 6.9.3 personalizzato;
  • Aggiornamento completo del sistema;
  • Aggiornamenti firmware;
  • Correzione di bug minori;
  • Miglioramento di Volatility;
  • Aggiunta di nuovi strumenti e tool al menù;
  • Menù aggiornati.

La dimensione di quasi 17 GB rende questa distribuzione meno adatta per operazioni sul campo, come ad esempio l’esecuzione di copia forense di hard disk, pendrive, SSD oppure acquisizione RAM, triage e anteprima, a causa della difficoltà di caricarla in RAM (es. con il comando da kernel “toram”) e delle risorse necessarie per l’esecuzione.

Rimane però ideale per un’installazione locale o per sfruttare la vasta gamma di strumenti offerti dagli sviluppatori. Attendiamo con interesse il rilascio della versione Tsurugi Acquire, pensata invece per eseguire copie forensi di supporti digitali con maggiore leggerezza e massima compatibilità con i vari sistemi su cui può essere avviata.